
Java 后端开发2025年面经与场景题(DeepSeek总结版)
目录指引:
面试场景题
典型场景题分类和示例
一、 系统设计与架构场景题 (重中之重)
这类问题旨在考察你如何从零开始或改造一个系统,评估你的技术选型、权衡和宏观思考能力。
- 经典系统设计
- 设计一个秒杀系统:这是最经典的场景。面试官会期待你谈到:
- 流量削峰:如何用消息队列(如RabbitMQ, Kafka)缓冲瞬时巨额流量。
- 缓存预热:如何提前将商品库存等信息加载到Redis等缓存中。
- 库存扣减:如何在分布式环境下保证“超卖”问题(Redis Lua脚本、数据库乐观锁)。
- 限流与熔断:如何在前端(页面静态化)、网关、服务层进行限流(如Sentinel, Hystrix)。
- 无状态服务:如何保证服务可以水平扩展。
- 设计一个短链接系统:
- 短码生成算法(自增ID、哈希、随机数)及其优缺点。
- 存储设计(用什么数据库?如何分库分表?)。
- 高并发读(缓存策略)。
- 过期和清理策略。
- 设计一个微博/微信朋友圈Feed流系统:
- 推模式 vs 拉模式 的权衡,以及混合模式的应用。
- 如何存储海量数据(分库分表策略)。
- 如何保证好友发布新状态后,我能及时看到(推模式下的异步任务、扇出)。
- 设计一个分布式ID生成器:
- UUID、数据库自增、Snowflake算法、Leaf-segment、Leaf-snowflake等方案的原理和选型考量。
- 设计一个秒杀系统:这是最经典的场景。面试官会期待你谈到:
- 现有系统优化与重构
- “我们有一个系统,随着业务发展,数据库CPU经常100%,你有什么排查思路和优化方案?”
- 考察点:SQL优化、索引优化、读写分离、引入缓存、分库分表、归档历史数据。
- “一个RPC接口调用超时,如何从后端的角度进行排查?”
- 考察点:全链路监控、日志分析、数据库慢查询、网络问题、GC问题、下游服务瓶颈。
- “如何将一个庞大的单体应用拆分为微服务?你会考虑哪些因素?”
- 考察点:领域驱动设计(DDD)、服务边界划分(高内聚、低耦合)、数据一致性(Saga、TCC)、分布式事务、API网关。
- “我们有一个系统,随着业务发展,数据库CPU经常100%,你有什么排查思路和优化方案?”
二、 高并发与性能优化场景题
这类问题考察你在压力下保证系统稳定性和高性能的能力。
- 缓存相关
- “如何保证缓存与数据库的双写一致性?”(经典难题)
- 考察点:Cache-Aside模式、延时双删、串行化、最终一致性理解。
- “缓存穿透、缓存击穿、缓存雪崩分别是什么?你的解决方案是什么?”
- 穿透:布隆过滤器、缓存空对象。
- 击穿:互斥锁、永不过期。
- 雪崩:随机过期时间、集群高可用、多级缓存。
- “为什么选择Redis而不是Memcached?Redis的持久化机制(RDB/AOF)如何选择?”
- “如何保证缓存与数据库的双写一致性?”(经典难题)
- 数据库与锁
- “在秒杀场景中,有100个商品库存,10万人来抢,如何保证不超卖?”
- 考察点:乐观锁(
version字段)、悲观锁(select ... for update)、Redis递减(Lua脚本保证原子性)。
- 考察点:乐观锁(
- “什么是死锁?如何在Java中定位和避免死锁?”
- 考察点:
jstack命令分析线程堆栈、避免顺序不一致、使用尝试锁。
- 考察点:
- “你们项目里分库分表是怎么做的?如何选择分片键?遇到跨分片查询/排序怎么办?”
- 考察点:对ShardingSphere、MyCAT等中间件的理解,或自己设计的思路。
- “在秒杀场景中,有100个商品库存,10万人来抢,如何保证不超卖?”
三、 分布式与微服务场景题
考察你对分布式系统复杂性的理解和处理能力。
- 事务与一致性
- “在微服务架构下,如何实现分布式事务?”
- 考察点:本地消息表、最大努力通知、TCC、Saga模式、Seata框架。
- “CAP理论是什么?你的系统如何取舍?BASE理论呢?”
- “在微服务架构下,如何实现分布式事务?”
- 服务治理与稳定性
- “服务注册与发现的原理是什么?(Eureka, Nacos)”
- “如何实现服务的熔断和降级?原理是什么?(Hystrix, Sentinel)”
- “如果服务A调用服务B,B又调用C,C挂了导致整个链路卡住,怎么处理?”
- 考察点:超时设置、熔断器、线程池隔离。
四、 项目经验与线上问题排查场景题 (行为面试)
这类问题通过你过去的实际经历来评估你的能力。
- 项目深度
- “介绍一个你做过的最有挑战的项目/模块。”
- STAR法则:情境、任务、行动、结果。重点讲清楚你个人的贡献和技术决策。
- “在这个项目中,你遇到的最大技术难点是什么?你是怎么解决的?”
- “如果让你重做这个项目,你会在架构上做什么改进?”
- “介绍一个你做过的最有挑战的项目/模块。”
- 线上故障处理
- “讲一次你处理过的线上故障,从发现到解决的全过程。”
- 考察点:监控告警、日志排查、定位问题、紧急回滚/修复、复盘总结。
- “如何排查Java应用的CPU占用率过高或内存泄漏问题?”
- 考察点:
top->jstack查线程、jmap/jstat分析GC、MAT分析堆转储。
- 考察点:
- “讲一次你处理过的线上故障,从发现到解决的全过程。”
五、 技术深度与原理性场景题
5年经验要求你对常用技术的理解不能停留在“会用”,而要深入原理。
- JVM
- “线上Full GC频繁,如何排查和优化?”
- “JVM调优你做过吗?常用的参数有哪些?(如堆大小、垃圾收集器选择)”
- 框架 (Spring)
- “Spring Bean的生命周期是怎样的?”
- “Spring事务的实现原理是什么?什么情况下会失效?”
- 消息队列
- “如何保证消息不被重复消费?(幂等性)”
- “如何保证消息的可靠传输?(生产者确认、消息持久化、消费者确认)”
- “Kafka为什么吞吐量高?(页缓存、顺序IO、零拷贝)”
场景一:设计一个秒杀系统
这是面试的“标配”题,完美考察高并发、高性能、高可用的架构能力。
回答思路: 分层削峰、冗余缓存、极限优化、预案兜底。
详细答法:
“面试官好,设计一个秒杀系统,我会从架构分层的角度,从前到后,逐层进行设计和优化。”
- 前端/接入层优化
- 目的:拦截80%以上的无效流量,尽量让请求不打到后端服务。
- 措施:
- 静态化:将商品详情页、活动页等提前生成静态HTML/CDN缓存,直接返回,不经过后端服务。
- 按钮置灰与计数:前端在活动开始前将按钮置灰,通过JS进行倒计时,防止用户提前重复提交。同时,用户点击后立即置灰,防止连点。
- 验证码:在提交秒杀请求时,弹出图形/滑动验证码,可以有效防止机器人刷单,并起到“削峰”作用。
- 网关层优化
- 目的:全局流控,恶意请求拦截。
- 措施:
- 限流:使用网关(如Spring Cloud Gateway, Nginx)配置严格的限流规则,例如对同一个UID/IP在短时间内进行次数限制。可以使用令牌桶或漏桶算法。
- 防刷:识别并拦截恶意IP、设备指纹等。
- 服务层优化(核心业务逻辑)
- 目的:将同步业务异步化,保证核心流程的可靠与高性能。
- 架构:采用微服务拆分,秒杀活动管理、商品查询、订单服务等各自独立,便于扩容和隔离。
- 措施:
- 缓存预热:在秒杀开始前,将参与秒杀的商品库存(例如100个)提前加载到Redis中。
- 请求入队:用户秒杀请求到达后,不做复杂的库存扣减和订单创建,而是进行基础的校验(如用户资格、活动是否进行中)后,生成一个唯一的请求ID,立即放入消息队列(如Kafka/RocketMQ) 中,并立即给前端返回“排队中”的状态。这一步是核心,将同步的秒杀请求变成了异步处理。
- 令牌(Ticket)机制:放入队列的其实是一个“资格”,后端服务异步地从队列中消费,判断库存,如果成功,则为这个请求生成一个购买令牌(Token),用户凭此令牌在有效期内完成支付即可。
- 数据层优化
- 目的:解决数据库的“写”瓶颈,防止超卖。
- 库存扣减:
- 方案一(首选):在Redis中预扣库存。使用
decr命令或Lua脚本来保证原子性。因为Redis是单线程内存操作,性能极高。扣减成功后,再将订单信息异步落库。 - 方案二(备用):如果必须用数据库,使用乐观锁(
update stock set count = count - 1 where product_id = xx and count > 0),通过count > 0和行级锁来防止超卖。
- 方案一(首选):在Redis中预扣库存。使用
- 订单创建:订单服务消费MQ消息,创建订单。这里数据库依然是瓶颈,可以考虑使用分库分表策略。
- 容灾与降级
- 目的:凡事做最坏的打算。
- 措施:
- 服务熔断与降级:如果订单服务或数据库压力过大,通过Sentinel/Hystrix进行熔断,暂时屏蔽秒杀功能,保护系统不被打垮。
- 预案:准备好开关配置,在系统出现问题时能一键关闭秒杀入口。
- 监控与告警:全链路监控(APM)、大盘、关键指标(QPS、库存消耗速度、DB负载)的告警必不可少。
总结陈述: “总之,一个秒杀系统的核心思想是‘分层过滤,逐级削峰’。前端拦截大部分无效请求,网关进行全局控流,服务层通过‘请求入队’将瞬时高峰 flatten 成平稳的异步流,最后在数据层通过Redis等高性能中间件解决核心的库存并发问题,并辅以完善的监控和降级预案来保证系统的最终稳定。”
场景二:如何保证缓存与数据库的双写一致性?
这是一个技术深度题,考察你对分布式数据一致性的理解。
回答思路: 没有银弹,根据不同业务场景(对一致性要求的强弱)选择最合适的方案。
详细答法:
“面试官好,缓存双写一致性问题没有一个完美的通用方案,需要根据业务场景进行权衡。主要有以下几种思路:”
- Cache-Aside Pattern(旁路缓存模式) - 最常用
- 读:先读缓存,命中则返回;未命中则读数据库,然后写入缓存。
- 写:先更新数据库,再删除缓存。
- 为什么是删除缓存,而不是更新缓存?
- 如果更新缓存,在并发写时,可能出现更新顺序问题,导致缓存中是旧数据。
- 删除缓存是一种懒惰加载的方式,下次读请求自然会从数据库加载最新数据。
- 存在的问题:
- 场景一:读请求A未命中缓存,读数据库(旧数据)。此时写请求B更新了数据库并删除了缓存。然后A把读到的旧数据写入了缓存。导致缓存一直是旧数据。
- 概率:这个场景需要满足(1)读缓存miss (2)一个写请求在读请求读库和写缓存之间完成。因为写操作通常比读操作慢,所以概率较低。
- 场景二:先删缓存,再更新数据库。在并发下,很容易导致另一个读请求在删缓存后、更新数据库前,把旧数据读出来并塞回缓存。这个概率很高,不推荐。
- 场景一:读请求A未命中缓存,读数据库(旧数据)。此时写请求B更新了数据库并删除了缓存。然后A把读到的旧数据写入了缓存。导致缓存一直是旧数据。
- 采用延时双删策略 - 优化方案
- 步骤:
- 先删除缓存。
- 再更新数据库。
- (关键)休眠一个短暂的时间(如几百毫秒,根据业务决定)。
- 再次删除缓存。
- 目的:第二次删除是为了清理在“更新数据库”这个时间窗口内,可能被其他读请求写入的旧数据。
- 缺点:引入了延时,降低了吞吐量。
- 步骤:
- 强一致性方案 - 复杂度高,特定场景使用
- 思路:通过订阅数据库的Binlog(使用Canal/Debezium等中间件)来异步更新/删除缓存。
- 流程:业务代码只更新数据库。一个独立的中间件订阅Binlog,当解析到数据变更时,再去操作Redis。
- 优点:业务代码简洁,将缓存与数据库的同步解耦。
- 缺点:有短暂延迟,架构更复杂。为了保证顺序,可能需要单线程消费。
总结陈述: “所以,在实际项目中,我们最常用的是 ‘先更新数据库,再删除缓存’ 的Cache-Aside模式,因为它简单有效,不一致的概率较低。如果对一致性要求极高,我们会结合‘延时双删’来进一步降低风险。而在一些允许秒级延迟、但追求架构解耦的场景,我们会考虑通过订阅Binlog的方案。没有最好的方案,只有最适合业务场景的方案。”
场景三:讲一次你处理过的线上故障
这是行为面试题,考察你的实际经验、排查问题的逻辑性和复盘能力。
回答思路: 使用STAR法则,并突出你的排查方法论。
详细答法:
“面试官好,我分享一次我们系统遇到的CPU 100%的线上故障。”
- S(情境): “当时是在一个工作日午后,监控平台突然告警,显示我们核心交易服务的几台服务器CPU使用率飙升到100%,导致大量API响应超时,影响了部分用户下单。”
- T(任务): “我的任务是立即定位问题根因,并尽快恢复服务,将影响降到最低。”
- A(行动): (这是重点,要体现你的排查链条)
- 确认现象与止损:我首先登录服务器,用
top命令确认了是某个Java进程占用了几乎全部CPU。同时,我立刻联系运维同学,先对其中一台机器做流量切出(摘流),保留现场用于排查,让其他机器继续提供服务,避免全盘崩溃。 - 定位问题线程:对摘流的机器,我用
top -Hp [pid]看到有一个线程的CPU占用异常高。 - 分析线程栈:我将这个高CPU线程的ID转换为16进制,然后用
jstack [pid] | grep -A 20 [nid]命令打印出这个线程的堆栈信息。发现这个线程正处于 ‘RUNNABLE’ 状态,并且堆栈信息显示它正在频繁地执行一个日志打印操作。 - 深入代码:我立刻去检查了这段日志相关的代码,发现是一个循环体里,在
DEBUG级别下,使用了logger.debug("Processing data: " + largeObject.toString())这种方式来拼接字符串。而largeObject是一个非常大的JSON对象。 - 根因分析:
- 即使在
INFO级别,由于字符串拼接发生在传入debug方法之前,所以无论级别如何,这个耗时的字符串拼接操作都会执行。 - 当时正好有同事为了排查另一个问题,在线上临时将日志级别改为了
DEBUG,触发了这个“性能炸弹”。 - 大量的字符串创建和拼接,导致了疯狂的GC和CPU占用。
- 即使在
- 确认现象与止损:我首先登录服务器,用
- R(结果): “找到原因后,我们立刻将日志级别改回
INFO,服务器CPU在十几秒内恢复正常。随后,我们修复了代码,将其改为使用logger.debug("Processing data: {}", largeObject)这种占位符的方式,确保在日志级别不匹配时不会有无谓的消耗。最后,我们在团队内进行了复盘,并制定了代码规范,禁止在日志中直接进行字符串拼接,同时加强了上线前对日志代码的审查。”
这个回答展现了: 应急能力(先止损)、排查方法(从现象到线程到代码)、技术深度(理解JVM、日志框架原理)、闭环能力(修复和预防)。
场景四:在微服务架构下,如何实现分布式事务?
考察你对分布式系统理论和技术落地的掌握。
回答思路: 从理论(CAP/BASE)到实践(具体方案),并说明选型考量。
详细答法:
“面试官好,在微服务架构下,我们放弃了传统的强一致性分布式事务(如XA/2PC),因为它性能差、同步阻塞,不符合微服务高可用的要求。我们转向追求最终一致性,基于BASE理论。常见的方案有几种:”
- 可靠消息最终一致性(异步确保型)
- 场景:适用于跨服务的异步任务,如订单成功后发短信、扣减库存。
- 方案一(本地消息表):
- 在业务数据库中,与业务数据同库同表,有一张“本地消息表”。
- 业务执行时,在一个本地数据库事务中,既要完成业务操作,也要向消息表插入一条记录。
- 有一个定时任务,扫描消息表,将消息发送到MQ。
- 下游服务消费MQ,处理业务。处理成功后,通知上游或上游主动回调来更新消息状态。
- 方案二(使用RocketMQ事务消息):
- 生产者发送一个“半消息”到MQ。
- MQ持久化成功并回复生产者。
- 生产者执行本地事务。
- 根据本地事务执行结果,向MQ提交
Commit或Rollback。 - MK如果收到Commit,则下游服务可见并消费;如果超时未收到,则回查生产者的本地事务状态。
- 核心:通过MQ的可靠性,保证只要上游事务成功,消息最终一定能被下游消费。
- TCC模式
- 场景:适用于对一致性要求高、且业务逻辑可以明确分为两阶段的场景,如资金扣款、酒店预订。
- 流程:
- Try:尝试执行。完成所有业务的检查,并预留必需资源(如冻结部分金额、锁定酒店库存)。
- Confirm:确认执行。真正执行业务,使用Try阶段预留的资源。要求幂等。
- Cancel:取消执行。释放Try阶段预留的资源。要求幂等。
- 优点:性能较好,数据最终一致。
- 缺点:业务侵入性强,需要为每个操作实现三个接口,开发复杂。
- Saga模式
- 场景:适用于业务流程长、需要调用多个服务的场景。
- 流程:将一个分布式事务拆分为多个本地事务,每个本地事务都有对应的补偿操作。
- 执行方式:
- 正向:T1 -> T2 -> T3 …
- 补偿:如果T3失败,则执行 C3 -> C2 -> C1 …(反向补偿)。
- 优点:一阶段就提交本地事务,无锁,高性能。
- 缺点:不保证隔离性,可能出现“脏写”,需要业务上能处理或通过其他手段避免。
总结陈述: “在我们的项目中,绝大部分场景使用的是‘可靠消息最终一致性’,因为它对业务侵入较小,通过MQ和补偿机制能很好地满足需求。对于少数核心的资金类业务,我们会采用TCC模式。同时,我们也会使用Seata这样的分布式事务框架来降低这些模式的实现复杂度。选型的核心在于权衡业务对一致性的要求与系统的复杂度和性能。”
面经一:博奥特 - 华安保险
Q:Redis 缓存与 Java 本地缓存的区别
核心定义
- Java 本地缓存:指在 Java 应用程序的 JVM 堆内存(或堆外内存)中开辟一块空间,用于存储数据。它的生命周期与应用程序保持一致,访问速度极快,但无法被其他应用共享。常见的实现有:
ConcurrentHashMap、Guava Cache、Caffeine、Ehcache等。 - Redis 缓存:一个独立的、基于内存的键值数据库,通常以独立的服务器进程形式存在,通过网络协议(如 RESP)与应用程序进行通信。它支持数据持久化、主从复制、集群分片等高级功能,是一个集中式的缓存解决方案。
详细对比分析
| 特性维度 | Java 本地缓存 | Redis 缓存 |
|---|---|---|
| 架构与位置 | 进程内缓存,与应用同属一个 JVM 进程。 | 进程外缓存,独立的服务,通过网络访问。 |
| 性能 | 极高。直接读写 JVM 内存,无网络开销和序列化/反序列化开销。 | 高。基于内存,但存在网络 I/O 和序列化/反序列化的开销。 |
| 数据一致性 | 难保证。在集群环境下,每个应用实例的本地缓存是独立的,更新一个实例的缓存无法通知其他实例,导致数据不一致。 | 易保证。作为集中式存储,所有应用实例都访问同一个数据源,数据是一致的。 |
| 分布式支持 | 不支持 或 需要额外手段。本身是单机的。要实现分布式效果,需要引入广播机制(如 Redis Pub/Sub)或一致性哈希等复杂方案。 | 原生支持。通过 Redis Cluster 或客户端分片,可以轻松实现水平扩展。 |
| 容量与扩展性 | 受 JVM 堆内存限制。容量有限,过大的缓存会影响 GC,可能引发 Full GC 甚至 OOM。扩展性差,只能垂直扩展(加大 JVM 堆)。 | 容量独立,扩展性强。数据存储在独立的 Redis 服务器上,容量不受应用限制。可以水平扩展(增加 Redis 集群节点)。 |
| 数据结构和功能 | 简单。通常是简单的 Key-Value 映射。高级功能(如过期、淘汰策略)需要自行实现或依赖第三方库(如 Caffeine)。 | 极其丰富。支持字符串、列表、集合、有序集合、哈希、位图、流等多种数据结构。提供发布订阅、Lua 脚本、事务等强大功能。 |
| 数据持久化 | 通常不持久化。应用重启后缓存数据丢失。 | 支持持久化。可通过 RDB 快照和 AOF 日志将内存数据持久化到磁盘,保证数据不丢失。 |
| 可靠性/高可用 | 低。缓存数据与应用共存亡,应用宕机则缓存丢失。 | 高。通过 Redis Sentinel 或 Redis Cluster 提供主从复制和故障自动转移,实现高可用。 |
| 使用复杂度 | 低。引入 jar 包即可使用,无需部署和维护额外中间件。 | 中。需要单独部署、维护和监控 Redis 服务器,增加了运维成本。 |
| 适用场景 | - 数据量不大、更新频率低 - 对性能要求极致,可接受短暂不一致 - 单机应用或无需在集群间同步缓存的场景 - 作为 Redis 缓存前的第一道屏障(多级缓存) | - 大规模分布式系统,需要缓存共享 - 数据一致性要求高 - 缓存数据量巨大 - 需要利用丰富的数据结构或功能(如排行榜、消息队列) - 需要高可用和数据持久化 |
场景举例与选择策略
1. 适合使用 Java 本地缓存的场景
- 配置信息缓存:例如,系统启动时加载的、很少变化的配置项、字典数据。每个应用实例在本地缓存一份,访问速度最快。
- 短时间高频访问的只读数据:比如,一分钟内不会变动的商品基本信息。即使各实例间有一分钟的差异,业务上也可接受。
- 多级缓存架构的第一级:在请求到达 Redis 之前,先用本地缓存拦截一次,极大减轻 Redis 的压力和网络延迟。这是非常经典的架构模式。
2. 适合使用 Redis 缓存的场景
- Session 共享:在集群部署中,用户的 Session 信息存储在 Redis 中,任何一台应用服务器都能访问,实现登录状态的保持。
- 分布式锁:利用 Redis 的原子操作实现跨 JVM 的互斥锁。
- 排行榜/计数器:利用 Redis 的
ZSET(有序集合)可以轻松实现实时排行榜;利用INCR命令实现高性能的计数器。 - 缓存热点数据:如商品详情页、文章详情等,所有应用实例都从同一个 Redis 获取,保证数据一致。
最佳实践与结合使用:多级缓存
在现代高并发系统中,通常不会二选一,而是将它们结合使用,形成多级缓存,以兼顾性能和一致性。
经典的多级缓存架构(如 CPU 缓存架构):
- L1 缓存:Java 本地缓存 (Caffeine)
- 作用:抵御最热点的数据访问,响应速度在纳秒级。
- 策略:设置较短的过期时间(如 1-2 分钟),容忍极短时间的数据不一致。
- L2 缓存:Redis 分布式缓存
- 作用:作为共享缓存层,抵御大量的数据访问,保证集群数据一致性。
- 策略:设置较长的过期时间,并从数据库加载数据。
- 数据源:数据库 (MySQL等)
- 最终的数据持久化层。
工作流程:
- 请求到达应用。
- 首先查询 L1 本地缓存,如果命中则直接返回。
- 如果 L1 未命中,则查询 L2 Redis 缓存。
- 如果 Redis 命中,则将数据写入本地缓存(并设置短过期时间),然后返回。
- 如果 Redis 也未命中,则查询数据库,将结果写入 Redis 和本地缓存,然后返回。
缓存更新/失效策略: 为了保证数据最终一致性,当数据发生变更时:
- 更新数据库。
- 删除 Redis 中对应的缓存(Cache-Aside 模式)。
- 发布一个消息(通过 Redis Pub/Sub 或 MQ),通知所有应用实例删除其本地缓存中的该数据。
总结
| 缓存类型 | 优势 | 劣势 |
|---|---|---|
| Java 本地缓存 | 性能极致、零网络开销、实现简单 | 容量有限、数据不一致、可靠性低 |
| Redis 缓存 | 功能丰富、数据一致、容量大、高可用 | 存在网络延迟、需要额外运维 |
最终选择建议:
- 追求极致性能、可接受数据短时不一致 -> 优先考虑 Java 本地缓存。
- 需要数据共享、保证一致性、缓存大量数据 -> 必须使用 Redis 缓存。
- 构建高性能、高可用的超大规模系统 -> 采用 多级缓存架构,让两者协同工作,取长补短。
Q:Redis 为什么这么快?
1. 基于内存的存储与访问
这是最根本、也是最容易理解的原因。
- 直接内存操作:Redis 将所有数据存储在内存(RAM)中。这意味着数据的读写操作完全不需要磁盘 I/O,而磁盘 I/O(尤其是机械硬盘)通常是传统数据库(如 MySQL)最主要的性能瓶颈。
- 速度数量级差异:内存的读写速度比 SSD 快 10-100 倍,比机械硬盘快 10万 倍以上。这种硬件级别的速度优势是 Redis 高性能的基石。
类比:从内存中读取数据就像从办公桌的桌面上直接拿一份文件,而从磁盘读取数据则像是需要走到档案室去翻找。前者几乎是瞬时的。
2. 高效的数据结构
Redis 不仅仅是简单的 Key-Value 存储,它提供了丰富的数据结构,并且每种结构都针对特定场景进行了极致的优化。
- 动态字符串(SDS):与 C 语言原生字符串相比,SDS 获取字符串长度的时间复杂度是 O(1)(原生是 O(n)),并且避免了缓冲区溢出,同时减少了内存重分配次数。
- 字典(Hash Table):Redis 的整个 Key 空间就是一个巨大的字典,其实现使用了高效的哈希表,并采用了一种称为 “渐进式 Rehash” 的策略。在扩容时,它不会一次性将所有数据迁移到新哈希表,而是分多次、渐进式地完成,避免了单次操作导致的长时间停顿,保证了高性能。
- 跳跃表(Skip List):用于实现有序集合(Sorted Set)。它在链表的基础上增加了多级索引,使得查找效率可以达到平均 O(log n),且实现比平衡树更简单,非常适合范围查询。
- 压缩列表(ziplist) 和 快速列表(quicklist):
ziplist是为小数据量列表、哈希、有序集合设计的一种紧凑的、连续内存存储结构,它通过牺牲部分读写速度来极大地节省内存,从而减少内存分配和碎片。quicklist是列表(List)的默认实现,它是双向链表和 ziplist 的结合。它将多个 ziplist 节点用双向链表连接起来,在空间效率和操作效率之间取得了完美的平衡。
- 紧凑存储:对于整数集合等,Redis 会使用最紧凑的编码方式来存储,以节省内存。
这些精心设计的数据结构,使得 Redis 在时间和空间效率上都达到了很高的水平。
3. 单线程模型与 I/O 多路复用
这是 Redis 设计中最精妙也最容易被误解的一点。
核心是单线程
Redis 的核心网络事件处理器(命令执行器)是单线程的。这意味着在任何给定时刻,只有一个命令在被处理。
为什么单线程反而快?
- 避免了线程切换和竞态的开销:多线程编程需要复杂的锁机制来保证数据一致性,锁的竞争和线程上下文的切换会消耗大量的 CPU 资源。单线程模型完全避免了这些开销。
- 不存在加锁/解锁操作:所有操作都是原子的,不会因为并发问题导致数据混乱,简化了实现。
- 顺序执行,无需同步:命令按照到达顺序被逐一执行,逻辑清晰,性能可预测。
I/O 多路复用:单线程的“神助攻”
单线程如何处理海量的并发连接呢?答案是 I/O 多路复用技术。
- 原理:Redis 使用
epoll(Linux)、kqueue(BSD/Mac) 或select等系统调用,在一个线程中同时监控成千上万个网络连接(Socket)。当任何一个 Socket 有数据到达(即有客户端请求)时,多路复用器会通知 Redis,然后 Redis 依次处理这些就绪的 Socket 上的命令。 - 工作流程:
- 多个客户端与 Redis 建立连接。
- Redis 的单线程通过 I/O 多路复用器监听所有 Socket。
- 当某个 Socket 可读(有请求)时,多路复用器将其放入一个队列。
- Redis 的事件处理器按顺序从队列中取出请求,逐个执行命令。
- 执行完毕后,将结果写入对应的 Socket 输出缓冲区。
类比:单线程的 Redis 就像一个高效的餐厅服务员。I/O 多路复用就像他有一个“万能对讲机”,可以同时监听所有餐桌(客户端)的点餐需求。他不需要在每张桌子前傻等,而是当有顾客(Socket)准备好点餐(请求可读)时,对讲机会通知他,他再走过去处理。这样,一个服务员就能高效地服务整个餐厅。
结论:单线程模型 + I/O 多路复用,使得 Redis 在极高的并发连接下,依然能保持极低的延迟和极高的吞吐量,尤其是在操作都是内存级别的轻量级操作时。
4. 其他优化手段
除了上述三大核心原因,Redis 还有一些其他的优化策略:
- 虚拟内存机制:虽然数据在内存中,但 Redis 仍会利用操作系统的虚拟内存和交换分区,不过现代 Redis 版本更倾向于使用持久化机制来保证数据安全。
- 管道化(Pipeline):客户端可以将多个命令一次性发送给 Redis,而无需等待每个命令的响应。这极大地减少了网络往返时间(RTT),在需要执行大量命令时效果显著。
- 精细的底层优化:Redis 的代码非常简洁高效,由 C 语言编写,对常见操作进行了大量优化。
总结与权衡
| 特性 | 带来的速度优势 | 潜在的代价/限制 |
|---|---|---|
| 内存存储 | 极快的读写速度 | 数据容量受内存大小限制,成本较高,数据易失(需配合持久化) |
| 高效数据结构 | 节省内存,操作快速 | 数据结构复杂度较高,需要根据场景选择合适的数据类型 |
| 单线程模型 | 无锁,无上下文切换,原子操作 | 无法利用多核CPU;单个耗时命令(如keys *)会阻塞所有后续命令 |
| I/O 多路复用 | 高并发连接下的高性能 | 对CPU密集型任务不友好 |
关于多线程的补充: 从 Redis 4.0 开始,为了弥补单线程在特定任务上的短板,Redis 引入了多线程,但主要用于后台任务,如:
- 大 Key 的异步删除(
UNLINK命令)。 - 持久化时 AOF 文件的刷盘操作。
在 Redis 6.0 及之后,进一步引入了多线程 I/O,用于处理网络数据的读取和解析(read/parse),但命令的执行(exec)仍然是单线程的。这进一步提升了在网络 I/O 成为瓶颈时的性能,而其核心的、无锁的命令执行模型依然得以保留。
最终结论: Redis 的极速是 内存速度 + 精妙数据结构 + 单线程无锁架构 + I/O 多路复用 这一组合拳的结果。它通过牺牲数据规模(受限于内存)和通用性(不适合复杂事务和CPU密集型任务),换取了在特定场景下无与伦比的性能。
Q:Redis 中 RDB 和 AOF 的区别
核心概念速览
- RDB:在指定的时间间隔内,生成内存中整个数据集的一个时间点快照。它就像是给数据库拍一张完整的照片。
- AOF:记录服务器接收到的每一个写操作命令,并在服务器启动时通过重新执行这些命令来重建原始数据集。它就像是记录数据库所有操作的日记。
下面我们从多个维度进行详细对比。
详细对比表格
| 特性维度 | RDB | AOF |
|---|---|---|
| 持久化原理 | 定时生成内存数据的二进制快照文件。 | 记录每一次写操作命令(文本协议格式),通过重放命令恢复。 |
| 文件格式 | 紧凑的、二进制的 dump.rdb 文件。 | 文本文件,默认名为 appendonly.aof,内容是可读的 Redis 命令。 |
| 数据安全性 | 较低。可能丢失最后一次快照之后的所有数据。 | 非常高。根据 appendfsync 策略配置,最多丢失一秒数据,甚至完全不丢。 |
| 性能影响 | 写时复制 机制,fork() 子进程时可能阻塞主线程,内存占用翻倍。恢复大数据集时速度快。 | 主要在于文件同步开销。appendfsync always 性能差,everysec 性能很好,no 性能最好但可能丢失更多数据。恢复大数据集时速度慢。 |
| 文件大小 | 小。二进制压缩格式,是某个时间点的数据全集。 | 大。记录所有操作日志,长期运行会非常大。但支持重写以压缩文件。 |
| 数据恢复速度 | 快。直接将 RDB 文件读入内存即可。 | 慢。需要逐条执行 AOF 文件中的所有命令,过程漫长。 |
| 容灾性 | 较差。损坏的 RDB 文件可能导致数据无法恢复。 | 较好。即使文件尾部有损坏,redis-check-aof 工具可以修复(截掉损坏部分)。 |
| 使用场景 | 适合大规模数据恢复、冷备份、对数据丢失不敏感(如数据统计、缓存)的场景。 | 适合对数据安全要求极高的场景,如业务核心数据、金融交易数据。 |
| 配置复杂度 | 简单,主要设置保存快照的时间策略。 | 相对复杂,需要配置 appendfsync 策略、AOF 重写策略等。 |
深入原理与细节分析
1. RDB 的工作机制与优缺点
工作原理:
- 手动触发:执行
SAVE(阻塞)或BGSAVE(后台异步)命令。 - 自动触发:在配置文件中设置
save m n规则,例如save 900 1表示在 900 秒内至少有 1 个 key 发生变化,则触发BGSAVE。 BGSAVE过程:Redis 主进程fork()一个子进程。子进程拥有主进程此刻的内存数据副本。子进程负责将数据写入临时 RDB 文件,写入完成后替换旧的 RDB 文件。父进程继续处理客户端请求。
优点:
- 性能最大化:
fork子进程进行持久化,主进程不会进行磁盘 I/O 操作,保证了 Redis 的高性能。 - 灾难恢复友好:紧凑的二进制文件非常适合用于灾难恢复,可以快速地将一个 RDB 文件转移到远程数据中心或对象存储中。
- 快速重启:相比 AOF,在数据集很大时,RDB 的恢复速度要快得多。
缺点:
- 数据丢失风险:由于是定时快照,一旦在两次快照之间数据库发生故障,会丢失这段时间内的所有数据。
fork()可能阻塞:当数据集非常大时(例如几十GB),fork()操作本身可能会非常耗时,导致主进程短暂停止服务(毫秒级甚至秒级)。
2. AOF 的工作机制与优缺点
工作原理:
- 命令追加:每一个写命令都会被追加到 AOF 缓冲区的末尾。
- 文件同步:根据
appendfsync配置,将缓冲区内容写入并同步到 AOF 磁盘文件。always:每个事件循环都将 AOF 缓冲区的内容写入并同步到 AOF 文件。最安全,性能最差。everysec:每个事件循环将 AOF 缓冲区内容写入到 AOF 文件,并且每秒同步一次。在安全性和性能之间取得了很好的平衡,是默认推荐的策略。no:每个事件循环将 AOF 缓冲区内容写入到 AOF 文件,但同步操作由操作系统决定。性能最好,但可能丢失一个事件循环的数据。
- 文件重写:随着命令不断写入,AOF 文件会越来越大。Redis 提供了
BGREWRITEAOF机制,fork子进程根据当前数据库状态创建一个新的、更小的 AOF 文件,来替换旧文件。例如,对一个 key 进行了 100 次incr,重写后只需记录一条set key 100命令。
优点:
- 极高的数据安全性:即使使用默认的
everysec策略,也最多只丢失 1 秒钟的数据。 - 可读性:AOF 文件是纯文本格式,易于理解和分析。如果误操作(如
FLUSHALL),可以在文件末尾删除该命令后进行恢复。
缺点:
- 文件体积大:即使经过重写,AOF 文件通常也比同数据集的 RDB 文件大。
- 恢复速度慢:数据恢复时需要重新执行所有命令,比 RDB 慢很多。
- 性能依赖同步策略:在写入吞吐量高的场景下,AOF 的性能可能仍低于 RDB。
如何选择:RDB vs AOF?
这是一个经典的权衡问题,取决于你的业务需求。
- 追求极致的数据安全,愿意牺牲一些性能和存储空间?
- 选择 AOF。这是最常见的选择。
- 可以容忍分钟级别的数据丢失,追求更快的启动速度和更小的备份文件?
- 选择 RDB。适用于用作缓存或存储非关键数据的场景。
- “我全都要”!希望兼顾数据安全、性能和快速恢复?
- 选择 “RDB + AOF” 的混合模式(Redis 4.0+ 推荐)。
混合持久化(推荐)
在 Redis 4.0 之后,引入了一个新的选项:aof-use-rdb-preamble。
工作原理: 当开启混合持久化后,在 AOF 重写时,子进程不再是单纯地将当前数据集转换为 AOF 命令,而是会先将当前数据集以 RDB 二进制格式写入到新的 AOF 文件的前半部分。然后,在重写期间接收到的写命令,会以 AOF 格式继续追加到文件的后半部分。
这样一来,新的 AOF 文件就由一个 RDB 数据快照头 和一个 AOF 命令增量尾 组成。
优势:
- 快速恢复:重启时,先加载 RDB 部分,速度极快,然后再重放少量的增量 AOF 命令,大大提升了恢复速度。
- 数据安全:结合了 RDB 的文件小、恢复快和 AOF 的数据不丢失的优点。
配置方法: 在 redis.conf 中设置:
appendonly yes
aof-use-rdb-preamble yes
总结与比喻
- RDB 像拍照片:定期定格,记录瞬间。恢复快、文件小,但可能错过镜头间的精彩(数据变化)。
- AOF 像写日记:事无巨细,逐条记录。数据全、最可靠,但日记本厚(文件大),复盘(恢复)起来慢。
- 混合模式像“照片+日记补录”:先拍一张完整的照片,然后在照片后面记录之后发生的新事情。结合了两者的优点,是现代 Redis 部署的推荐方案。
在实际生产环境中,强烈建议根据业务容忍度进行测试,并优先考虑开启 AOF 或 混合持久化 来保证数据的安全性。
Q:注重项目的难点
- 对项目二中系统对接上游系统与下游系统的数据传输方式,以及供应商是否存在外部系统导入数据进内部系统。
- 对于零部件询报价寻源系统,其数据来源通常是多通道、分阶段的,而不是单一来源。下图清晰地展示了该系统核心的数据来源与流向:
下面我们来分步解析这套数据流机制:
核心数据来源分析
- 来自东风日产内部系统(主要来源)
这是系统最核心、最正式的数据来源,保证了数据的权威性和一致性。
- 数据内容:需要询价的零部件清单(BOM)、车型信息、技术图纸、需求数量、时间节点等。
- 来源系统:
- PDT车型综合管理系统(项目描述中已提及):这是最直接的源头,新车型项目启动时,会生成完整的零部件清单,并自动或手动触发询价流程。
- ERP主数据系统:获取已有的物料基础信息、历史价格等。
- 设计/工艺系统:获取最新的技术规范和图纸。
- 交互方式:通常通过系统接口对接实现。PDT系统会通过API调用或消息队列,将询价任务同步到寻源系统。
- 来自内部用户(采购/工程师)的Excel导入
这是对系统对接方式的重要补充,用于处理非标、紧急或系统无法覆盖的场景。
- 数据内容:
- 新供应商引入时的初步物料清单。
- 临时、小批量的零星采购需求。
- 对已有数据的批量更新。
- 交互方式:这正是你职责中 “使用 CompletableFuture 并行导入零件数据” 和 “优化Excel导入” 所解决的问题。供应商不直接操作该系统,而是将Excel文件发给东风日产的采购人员,由内部员工统一导入,以保证数据的规范和安全。
- 来自供应商的数据(核心是报价,而非零件数据)
这里是关键的区分点:供应商提供的是“报价”数据,而非“零件”主数据。
- 供应商不直接导入零件数据:零件的基础信息(如零件号、名称、技术规格、图纸)是由东风日产定义和拥有的,供应商无权创建或修改。
- 供应商的核心操作:
- 在线报价:在系统中针对发布的询价单,填写单价、付款条件、交货周期等。
- 上传辅助文件:可能会上传报价明细、资质文件、技术建议等作为附件。
- 潜在的特殊情况:
- “供应商白名单”申请:新供应商可能会提交申请和资料,但这属于基础数据管理模块,而非询价流程本身。
- 替代方案建议:供应商可能在报价时,建议一个功能相似的替代零件,但这需要经过严格的审批流程才会被纳入系统。
面试专业回答话术
你可以这样清晰地向面试官阐述:
“在这个系统中,数据来源是双向的,但角色和数据类型是严格区分的。
首先,询价的‘零部件主数据’是由我们东风日产内部产生和定义的。 主要来自两个通道:
- 系统对接:例如从 PDT车型管理系统 通过接口自动同步过来,这是最主流、最规范的方式。
- 内部导入:由我们的采购或工程师,通过我优化过的 Excel导入功能,将整理好的零件清单批量录入系统。
然后,供应商在这个流程中,扮演的是‘报价响应方’的角色。 他们登录系统后,看到的是我们发布的、已定义好的零部件询价单,他们的核心操作是填写报价信息,而不是导入零件数据本身。这样保证了数据源的权威性和业务流程的规范性。”
为什么要这样设计?(展现你的架构思维)
- 数据主权与安全性:零部件基础数据是企业的核心资产,必须掌握在自己手中,防止供应商篡改或看到敏感信息。
- 流程标准化:统一的零件数据是进行**“苹果对苹果”比价**的前提。如果每个供应商都按自己的理解报不同的零件,比价就无法进行。
- 系统解耦:将数据定义(内部)与数据响应(供应商)分离,使得系统架构更清晰,易于维护和扩展。
这样回答,表明你不仅知道技术实现,更能从业务、流程和架构的角度理解一个系统的设计精髓。
Q:引入 MQ 对系统的增强
没有引入 MQ 之前的系统交互方式
在没有引入消息队列(MQ)之前,系统间的交互主要是同步调用和定时任务轮询的结合。
核心交互模式:
同步 HTTP/RPC 调用 (占主导)
场景:当上游系统(如PDT车型管理系统)有新的零部件数据需要发起询价流程时,会直接、同步地调用我们寻源系统的API接口。
代码逻辑 大致如下:
java// 在上游系统中 ResponseEntity<String> response = restTemplate.postForEntity( "http://xunyuan-system/api/startInquiry", inquiryRequest, String.class ); // 必须等待寻源系统的响应 if (response.getStatusCode().is2xxSuccessful()) { // 继续执行后续逻辑 } else { // 处理失败,可能要进行重试或记录错误 }
数据库轮询 (作为补充)
- 场景:对于一些非实时性的数据集成,比如老数据迁移(FDI集成),可能会采用一个定时任务,定期去扫描上游系统的数据库表或某个文件目录,发现有新数据后再进行拉取和处理。
这种方式带来的核心痛点:
- 系统紧耦合:上游系统的可用性直接影响了我们系统的可用性。如果我们系统因部署、故障或性能问题宕机,上游系统的调用会立即失败,导致业务流程中断。
- 性能瓶颈与延迟:上游系统必须等待我们系统的全部处理完成(如数据校验、入库、初始化流程等)后才能得到响应。如果我们的处理较慢,会直接拖慢上游系统的响应时间。
- 缺乏弹性与削峰能力:如果上游系统在某一时刻产生大量询价请求(例如新车发布),我们的系统必须能实时处理这些洪峰流量,否则可能导致服务雪崩。我们没有“缓冲地带”。
- 流程驱动困难:对于“供应商报价超时自动关闭”这类需要延迟触发的业务场景,实现起来非常笨重。通常只能通过一个定时任务,频繁地扫描数据库表,检查每个询价单的创建时间来判断是否超时。这对数据库压力大,且不精确。
引入RabbitMQ之后如何体现其强大作用
引入MQ后,系统架构从紧耦合的同步模型转变为松耦合的异步事件驱动模型,其强大作用体现在以下几个方面:
1. 解耦 (Decoupling) - 最核心的价值
- 之前:上游系统需要知道寻源系统的确切网络地址和接口,并与之直接通信。
- 之后:上游系统不再关心谁来处理这个请求,它只需要将一条消息(如
InquiryCreatedEvent)发送到RabbitMQ的特定交换机。我们寻源系统作为消费者,只需要监听这个交换机的消息即可。即使寻源系统正在重启或暂时不可用,消息也会安全地存储在RabbitMQ中,不会丢失。 系统间的依赖从“服务-服务”变成了“服务-消息队列-服务”。
2. 异步与削峰填谷 (Asynchrony & Buffering)
- 之前:一个耗时2秒的询价创建流程,会阻塞上游系统2秒。
- 之后:上游系统发送消息到MQ后,几乎可以立即返回成功响应,将实际的耗时处理抛在脑后。我们寻源系统可以按照自己的处理能力,从MQ中拉取消息并进行消费。突然到来的流量洪峰会被MQ这个“缓冲区”平滑掉,避免了系统被瞬间冲垮。
3. 增强业务能力与可靠性 (Enhanced Capabilities & Reliability) 这正是你项目中 “供应商报价超时自动关闭” 功能的完美体现。
- 之前:依赖低效的数据库轮询,难以实现。
- 之后:
- 当创建一个询价单时,系统会同步发送一条消息到RabbitMQ。
- 这条消息不设置消费者,并配置一个TTL(生存时间),比如48小时(报价窗口期)。
- 48小时后,消息因过期变成死信,会自动被路由到另一个队列——死信队列。
- 此时,我们有一个专门的消费者监听这个死信队列,一旦收到消息(即说明有询价单超时了),就自动执行关闭逻辑。
- 这种方式精准、高效、对数据库无压力,是MQ在解决复杂业务场景上的典范应用。
4. 最终一致性 (Eventual Consistency) 在与下游系统集成时,也可以通过MQ来保证最终一致性。例如,当设定“最优供应商”后,可以通过发布一个 SupplierSelectedEvent 事件,让物流管理系统、PDT系统等各自订阅并更新自己的状态,而不是通过脆弱的同步调用链。
面试回答话术建议
你可以这样组织语言:
“在引入RabbitMQ之前,系统间主要通过同步HTTP调用进行交互。这导致系统间耦合紧密,上游系统的稳定性直接制约着我们,并且缺乏对突发流量的削峰能力。
引入MQ后,我们实现了架构上的解耦和异步化。最典型的例子就是我们用
延时队列+死信队列完美地实现了供应商报价超时自动关闭功能。这个功能在之前需要通过低效的数据库轮询来实现,而现在由MQ内部机制自动触发,精准、高效且不增加数据库压力。总的来说,MQ的引入让我们的系统从脆弱的
请求-响应模型,进化成了更具弹性、可扩展性和可靠性的事件驱动架构。
这样回答,既清晰地对比了前后差异,又通过一个具体、有亮点的案例(延时队列)证明了你的技术深度和MQ的实际价值。
面经二:中软 - 招银云创
Q:分布式 CAP 原理
1. CAP 原理是什么?
CAP原理,也常被称为CAP定理,它指出对于一个分布式计算系统来说,不可能同时完全满足以下三个核心特性:
- C:一致性
- A:可用性
- P:分区容错性
该定理表明,在分布式系统中,当网络发生分区时,我们必须在一致性和可用性之间做出权衡,无法二者兼得。
理解CAP的关键在于认识到它是一个“三选二”的权衡,而不是一个“三选二”的完美方案。由于分区是分布式系统中无法避免的现实,P 实际上是我们必须选择的。因此,真正的选择是在 C 和 A 之间。
2. 深入理解三个核心概念
C:一致性
这里的“一致性”指的是 线性一致性 或 强一致性。它意味着,在任何一次数据读取操作中,系统都应该返回最近一次成功写入的数据。
- 通俗解释:对于所有连接到系统的客户端(无论连接到哪个节点),只要看到某个数据被更新了,那么之后的所有读操作,要么看到的是更新后的值,要么读取失败。系统表现得“好像”只有一个数据副本。
- 例子:你在一台机器上更新了某个值为
100,那么之后从任何其他机器上读取这个值,都必须是100。系统不会让你读到旧的50。
A:可用性
可用性指的是,系统的每一个非故障节点,对于每一个请求(无论读写)都必须给出一个非错误的响应(但不能保证响应中包含的数据是最新的)。
- 通俗解释:只要系统节点没宕机,它就必须响应客户端的请求,不能超时也不能报错。但响应的数据可能是旧的。
- 例子:即使发生了网络分区,导致某个节点无法与其他节点同步数据,它仍然需要处理客户端的读请求。它可能会返回自己本地的旧数据,但绝不会不响应。
P:分区容错性
分区容错性指的是,系统在遇到网络分区(即节点之间无法正常通信)的情况下,仍然能够继续对外提供服务。
- 通俗解释:网络不是100%可靠的,节点之间的网络可能会中断(比如光缆被挖断、交换机故障)。分布式系统必须能够容忍这种情况,部分节点组成的子网络依然可以独立运行,而不是整个系统崩溃。
- 例子:一个分布式系统由北京和上海的两个机房组成。如果它们之间的网络光缆断了,形成了两个无法通信的分区,系统设计上需要能处理这种情况。
3. 为什么不能同时满足?—— CAP 的三种场景
我们通过一个经典的例子来解释:一个由两个节点(Node A, Node B)组成的分布式数据库,它们之间通过网络同步数据。
场景一:满足 CA(放弃 P)
- 选择:保证一致性和可用性,放弃分区容错性。
- 如何实现:系统设计成当节点间无法通信(即发生分区)时,整个系统停止服务(不可用)。
- 结果:当网络正常时,系统是强一致且可用的。一旦网络发生分区,系统为了保持一致性(因为无法同步数据),只能选择不服务,从而牺牲了可用性。这实际上不是一个真正的分布式系统,因为它无法容忍网络故障。典型的单点数据库集群(如主从模式的MySQL,在主从断连时,主库可能被设置为只读或下线)在某些配置下接近这种模式,但严格来说,它们无法完全放弃P。
场景二:满足 CP(放弃 A)
- 选择:保证一致性和分区容错性,放弃可用性。
- 如何实现:当网络分区发生时,系统会锁定受影响的分区,阻止对其的读写操作,以确保数据不会出现不一致。只有那些能与其他大多数节点通信的分区可以继续工作。
- 结果:系统保证了数据的强一致性,但牺牲了部分节点的可用性。客户端连接到被锁定的分区时,会收到错误或超时。
- 典型系统:ZooKeeper, etcd, HBase, MongoDB(使用强一致性配置时)。在选举Leader或网络不稳定时,这些系统可能会短暂不可用。
场景三:满足 AP(放弃 C)
- 选择:保证可用性和分区容错性,放弃强一致性。
- 如何实现:当网络分区发生时,所有节点仍然可以处理读写请求。但这可能导致数据在不同节点上出现不一致(即“最终一致性”)。
- 结果:系统始终保持高可用,但读取的数据可能不是最新的。当网络分区恢复后,系统会通过一些机制(如冲突解决)来逐步达成一致性。
- 典型系统:Cassandra, DynamoDB, Riak, Eureka。这些系统在设计上优先保证可用性。
4. 对 CAP 的常见误解与澄清
- 误解一:CAP是“三选二”,可以任意选择。
- 澄清:P是分布式系统的固有属性,你无法选择“放弃P”,因为网络故障必然会发生。因此,真实的选择是在发生P时,是选择C还是选择A。在系统没有发生分区时,是可以同时实现CA的。
- 误解二:一个系统在整个生命周期中只能是CP或AP。
- 澄清:CAP是针对同一个数据对象的权衡。一个复杂的系统可以为不同的数据模型或不同的操作选择不同的策略。例如,一个系统可以对其核心用户数据采用CP策略,而对用户的会话数据采用AP策略。
- 误解三:放弃C意味着数据永远混乱。
- 澄清:放弃C通常是指放弃强一致性,转而采用最终一致性。系统会保证在未来的某个时间点(在没有新写入的情况下),所有副本的数据会变得一致。这期间会存在一个“不一致窗口”。
5. CAP在现代系统设计中的应用与延伸
BASE理论
为了弥补CAP中放弃强一致性带来的问题,eBay的架构师提出了BASE理论,它是对AP系统的一种实践性描述:
- Basically Available(基本可用):系统在出现不可预知故障时,允许损失部分可用性(如响应时间变长、部分功能降级)。
- Soft state(软状态):允许系统中的数据存在中间状态,并认为该状态不会影响系统的整体可用性(即各节点间的数据复制存在延迟)。
- Eventually consistent(最终一致性):经过一段时间后,所有数据副本最终会达到一致的状态。
BASE理论是构建高可用、可扩展互联网系统的指导思想,它通过牺牲强一致性来换取系统的灵活性和性能。
现实世界中的权衡
现代分布式数据库和中间件提供了灵活的配置,让开发者可以根据业务场景决定CAP的权衡。
- 银行账户、库存系统:对一致性要求极高,通常选择CP。
- 社交媒体点赞、用户会话:对可用性要求更高,可以接受短暂不一致,通常选择AP。
- 服务发现:在微服务架构中,服务发现组件(如Eureka选择AP,Consul选择CP)的不同选择直接影响了系统的行为。
总结
CAP原理是一个揭示分布式系统内在本质的简洁而深刻的模型。它告诉我们:
- 分区是必然发生的,设计系统时必须考虑。
- 在分区发生时,你无法同时保证强一致性和高可用性,必须做出选择。
- 这个选择没有对错,完全取决于你的业务需求。
- 理解CAP,不是为了背诵理论,而是为了在系统设计时做出明智的权衡。 当你设计一个功能时,问问自己:“如果现在网络断了,这个功能是应该报错(CP)还是继续用可能旧的数据提供服务(AP)?” 这个问题的答案,就是CAP原理在你系统中的具体体现。
Q:项目如何体现分布式系统
维度一:架构层面 - 微服务拆分与服务治理
采购公共服务系统(明确的微服务架构)
- 服务拆分:将庞大的ERP系统按业务域拆分为供应商服务、权限服务、评估服务、白名单服务等独立的微服务。
- 服务注册与发现:使用 Nacos 作为注册中心,各个微服务启动时向Nacos注册自己的网络地址,消费者通过服务名而非具体的IP地址来调用服务。
- 配置集中管理:使用 Nacos 作为配置中心,所有微服务的配置(如数据库连接、缓存地址、开关配置)集中管理,实现配置与代码分离和动态刷新。
零部件询报价寻源系统(内聚的微服务或分布式模块)
- 系统边界清晰:虽然项目描述未明确说微服务,但其作为独立系统,与 PDT系统、物流系统 等形成系统间的分布式架构。
- API网关模式:对外提供统一的RESTful API,下游系统通过HTTP调用,体现了面向服务的架构思想。
似乎出了点问题
维度二:数据层面 - 数据分布与一致性
分布式缓存(两个项目都用到了Redis)
- 共享会话:用户登录后,会话信息存储在Redis中,这样无论用户的请求被负载均衡到哪台应用服务器,都能识别其身份。解决了HTTP无状态协议在分布式集群下的状态保持问题。
- 共享数据:热点数据(如供应商信息、零件分类、配置信息)缓存在Redis中,所有服务实例共享同一份数据视图,避免每个实例都去查询数据库,保证数据的一致性和减轻数据库压力。
分布式数据源
- 读写分离与分库分表:你提到的"数据量特别大的表采用分库分表,读写分离的设计",这是数据层分布式的核心体现。数据被水平拆分到不同的数据库实例中,应用需要通过中间件或框架来路由数据访问。
最终一致性(通过消息队列实现)
- 采购系统:供应商状态变更后,通过MQ发送事件消息,让其他关心此状态的服务(如评估服务、白名单服务)异步更新自己的数据,实现数据的最终一致性,而不是强一致的分布式事务。
维度三:通信层面 - 服务间通信模式
同步通信(直接调用)
- RESTful HTTP:零部件系统调用PDT系统的接口获取零件数据,这是典型的同步跨系统调用。
- Feign/RestTemplate:在采购微服务架构内部,服务A通过HTTP客户端(如OpenFeign)调用服务B的接口。
异步通信(消息驱动)
- RabbitMQ的应用:
- 零部件系统:用延时队列+死信队列实现报价超时自动关闭。这是一个经典的基于事件的异步处理模式,将时间触发的逻辑从业务代码中解耦出来。
- 采购系统:服务间通过发布/订阅消息来通知业务事件的发生,实现服务解耦。一个服务完成工作后,不必知道也不关心有多少个其他服务需要感知这个事件。
维度四:容错与弹性层面
服务降级与熔断
- 当零部件系统调用PDT系统接口时,如果PDT系统响应缓慢或不可用,可以通过熔断器(如Hystrix或Sentinel) 快速失败,避免线程被长时间占用,导致自身系统也被拖垮。并可以返回降级数据(如默认配置或缓存中的旧数据),保证核心流程的可用性。
负载均衡
- 在微服务架构中,一个服务通常有多个实例。服务消费者(如Spring Cloud LoadBalancer)会从Nacos获取所有健康的实例列表,并通过负载均衡算法(如轮询、随机)选择一个实例进行调用,从而实现流量分发和高可用。
面试专业回答话术
你可以这样综合阐述:
"这两个项目从不同维度完整地体现了分布式系统的核心思想。
首先,在架构上,采购系统是典型的微服务架构,通过Nacos实现了服务的注册发现和配置集中管理;而零部件系统则体现了系统间的分布式,通过与PDT、物流等外部系统对接,形成了更大的分布式生态。
其次,在数据层,我们都使用了Redis作为分布式缓存来解决会话共享和热点数据问题,并且在大数据场景下采用了分库分表和读写分离,这是数据分布式的直接体现。
最关键的是在通信模式上,我们混合使用了同步的HTTP调用和异步的消息驱动。特别是用RabbitMQ实现的’报价超时自动关闭’功能,完美展现了如何通过消息队列来实现系统解耦和基于事件的最终一致性。
最后,在容错方面,我们通过熔断、降级、负载均衡等机制,来保证在部分依赖不可用时,整个分布式系统依然能保持弹性和可用性。
可以说,从服务治理、数据分布、通信模式到故障处理,这两个项目覆盖了构建一个成熟分布式系统所需要考虑的核心方面。"
这样的回答,展现了你对分布式系统全局的、深度的理解,而不仅仅是停留在技术组件的简单使用上,能够给面试官留下深刻的印象。
Q:OOM 与内存溢出区别
简单来说,它们的关系是:OOM是一个广泛的概念,而Java内存溢出是OOM在Java平台上的具体体现和细分。
1. OOM - 广义的系统级概念
OOM 是 Out Of Memory 的缩写,意为“内存耗尽”。这是一个通用术语,适用于任何计算环境(操作系统、应用程序、编程语言等)。
- 范围: 整个系统或单个进程。
- 根本原因: 程序或系统申请的内存总量,超过了物理内存(RAM)和交换空间(Swap)所能提供的最大容量。
- 触发者: 通常是操作系统内核的内存管理子系统。
- 结果:
- 在类Linux系统中,内核的 OOM Killer 进程会被触发。它会根据一套复杂的算法(参考
oom_score)选择一个或多个“罪魁祸首”进程并将其强制杀死,从而释放内存,保全系统的稳定性。 - 在Windows等系统中,可能会看到“系统资源不足”的提示,或者应用程序被直接终止。
- 在类Linux系统中,内核的 OOM Killer 进程会被触发。它会根据一套复杂的算法(参考
例子: 你同时打开了浏览器(很多标签页)、IDE、虚拟机、数据库,这些程序占用的总内存超过了你的8GB物理内存+8GB交换空间。此时,Linux系统可能会选择杀死你的MySQL进程,并报告一个OOM错误。
2. Java内存溢出 - 具体的JVM平台概念
Java内存溢出 特指在Java虚拟机中发生的内存耗尽情况。它发生在JVM这个“沙箱”内部。
- 范围: JVM进程内部。
- 根本原因: Java应用程序申请的内存,超过了 JVM内存模型(运行时数据区) 中某个特定区域(如堆、元空间等)的最大容量。
- 触发者: JVM自身。
- 结果: JVM会抛出
java.lang.OutOfMemoryError这个错误(注意,是Error,不是Exception),并通常会附带一个详细的错误信息来说明是哪个区域溢出了。JVM进程本身可能还在运行,但抛出错误的那个线程通常会终止。
Java内存溢出的细分类型(非常重要)
由于JVM内存模型划分了不同的区域,所以 OutOfMemoryError 也有不同的类型,这有助于我们精准定位问题:
Java heap space(堆空间溢出)- 原因: 这是最常见的OOM。对象实例主要在堆上分配。当创建了大量对象,并且有无法被垃圾回收的引用(即内存泄漏)时,就会发生堆溢出。
- 错误信息:
java.lang.OutOfMemoryError: Java heap space - 典型场景: 内存泄漏、过大的集合类缓存、加载了大量数据到内存等。
GC overhead limit exceeded(GC开销超出限制)- 原因: JVM花费了太多时间(默认超过98%)在进行垃圾回收,但每次回收的效果极差(默认回收不到2%的堆空间)。这本质上是堆空间问题的另一种表现,意味着堆快被“撑满”了,GC在徒劳地工作。
- 错误信息:
java.lang.OutOfMemoryError: GC overhead limit exceeded
Metaspace(元空间溢出)- 原因: 加载的类太多(如大量使用动态代理、反射、JSP),或类加载器泄漏,导致存储类元数据的元空间(Java 8+,取代了永久代)被占满。
- 错误信息:
java.lang.OutOfMemoryError: Metaspace
Unable to create new native thread(无法创建本地线程)- 原因: 这严格来说不是JVM内存模型的溢出,而是操作系统资源限制。JVM为每个线程分配栈内存(通常是操作系统本地内存,而非JVM堆)。创建了太多线程,耗尽了进程的地址空间或系统线程资源。
- 错误信息:
java.lang.OutOfMemoryError: unable to create new native thread
Requested array size exceeds VM limit(请求的数组大小超过VM限制)- 原因: 应用程序尝试分配一个大于堆大小的数组(例如,在32位JVM上尝试分配1GB的数组)。
- 错误信息:
java.lang.OutOfMemoryError: Requested array size exceeds VM limit
核心区别对比表
| 特性 | OOM (广义) | Java内存溢出 (具体) |
|---|---|---|
| 范围 | 整个操作系统或任意进程 | JVM进程内部 |
| 触发机制 | 操作系统内核(如OOM Killer) | JVM自身 |
| 表现形式 | 进程被强制杀死、系统卡顿 | 抛出 OutOfMemoryError 错误 |
| 错误信息 | 系统日志(如 dmesg) | JVM日志或异常堆栈,信息详细且分类 |
| 根本原因 | 系统总内存不足 | JVM特定内存区域(堆、元空间等)不足 |
| 影响范围 | 可能导致任何进程被杀 | 通常只影响抛出错误的JVM进程 |
联系与总结
- 包含关系: Java内存溢出是OOM的一种特定场景。当Java应用发生内存溢出时,从操作系统的视角看,就是这个JVM进程消耗了大量内存,它本身就可能成为系统级OOM Killer的目标。
- 视角不同:
- 系统管理员更关心广义OOM,因为它会影响整个服务器的稳定性。
- Java开发者更关心Java内存溢出,因为
OutOfMemoryError的错误类型能直接指导我们进行代码优化、JVM参数调优(如-Xmx,-XX:MaxMetaspaceSize)和问题排查(如使用MAT分析堆转储)。
简单比喻:
- 广义OOM 就像一座城市的电力系统超负荷,导致整个区域大停电。
- Java内存溢出 就像你家里的一个特定电器(比如空调)因为功率过高,跳了家里的空气开关,但邻居家不受影响。
OutOfMemoryError的错误信息会告诉你,是空调跳闸了,还是电热水器跳闸了。
Q:Java 内存溢出与内存泄漏的区别
什么是内存泄漏?
在理论上,Java有自动垃圾回收(GC),当一个对象不再被任何地方引用时,GC会自动回收它占用的内存。这似乎应该杜绝内存泄漏。
但实际情况是:内存泄漏在Java中指的是“无意中持有的、不再需要的对象引用,导致这些对象无法被GC回收,从而造成内存的持续消耗”。
核心思想: 对象已经不再被应用逻辑所需要,但因为某些原因,仍然被GC Roots 引用着,从而变得“该死却没死”。
一个简单的比喻
- 内存使用正常: 你从书架上拿了一本书阅读,读完后放回书架。
- 内存泄漏: 你拿了一本书阅读,读完后用一个大夹子把它夹在了书架上(这个夹子就是一个意外的引用)。你永远不会再读这本书,但它也永远无法被放回书箱(被GC回收)。你读的书越多,被夹住的书就越多,最终书架被塞满(内存溢出)。
Java 中典型的内存泄漏场景
以下是一些在Java开发中常见的内存泄漏场景:
1. 静态集合类滥用
静态集合(如 static HashMap, static List)的生命周期与整个应用程序一致(JVM进程)。
public class MemoryLeak {
    private static List<Object> staticList = new ArrayList<>();

    public void addToStaticList(Object obj) {
        staticList.add(obj); // 一旦加入,除非显式移除,否则对象将永远存在
    }
}
即使你不再需要 obj,它也因为被 staticList 引用而无法被回收。
2. 未关闭的资源(连接、流等)
数据库连接、网络连接、文件流等底层资源使用了 native memory(本地内存)或服务器资源。如果不关闭,不仅可能造成JVM内存压力,还可能拖垮整个服务。
try {
    Connection conn = dataSource.getConnection();
    // ... 业务逻辑
    // 忘记调用 conn.close();
} catch (SQLException e) {
    e.printStackTrace();
}
现代最佳实践是使用 try-with-resources 语法自动关闭。
3. 监听器和回调未注销
当你向一个全局的管理器注册了监听器(Listener)或回调(Callback),如果在对象不再使用时没有注销,那么管理器会一直持有该对象的引用。
public class MyService {
    public void register() {
        SomeManager.getInstance().addListener(this); // 注册
    }

    // 缺少 unregister 方法
}
4. 内部类持有外部类引用
非静态内部类(包括匿名内部类)会隐式地持有其外部类的引用。如果这个内部类的生命周期长于外部类(例如,被放入一个全局的线程池或队列),就会导致外部类实例也无法被回收。
public class OuterClass {
    private byte[] data = new byte[1024 * 1024]; // 占用大量内存

    public void createInnerClass() {
        InnerClass inner = new InnerClass();
        // 如果 inner 被一个长生命周期的线程持有,那么 OuterClass.this 也无法被回收
        SomeGlobalThreadPool.submit(inner);
    }

    class InnerClass implements Runnable {
        @Override
        public void run() {
            // 这里可以隐式访问 OuterClass.this.data
        }
    }
}
5. 缓存管理不当
使用缓存而不设置大小、过期时间或淘汰策略(如LRU),会导致缓存无限增长,最终引发OOM。
解决方案: 使用弱引用(WeakHashMap)或专业的缓存库(如Guava Cache, Caffeine),它们内置了大小和过期策略。
6. 线程局部变量(ThreadLocal)误用
ThreadLocal 为每个线程提供了一个独立的变量副本。但如果线程是线程池复用的(如Web容器的请求处理线程),那么线程的整个生命周期会非常长。如果在使用完 ThreadLocal 后没有调用 remove() 方法,那么其中存储的对象就会一直存在于线程的 ThreadLocalMap 中,造成泄漏。
private static ThreadLocal<User> userThreadLocal = new ThreadLocal<>();

public void handleRequest(Request request) {
    userThreadLocal.set(getUserFromSession(request));
    try {
        // ... 业务逻辑
    } finally {
        // 必须清理!
        userThreadLocal.remove(); // 如果没有这行,就会发生内存泄漏
    }
}
内存泄漏、内存溢出与 OOM 的关系
这三者构成了一个清晰的因果链:
- 原因:内存泄漏(Memory Leak)
- 由于代码缺陷,导致无用对象无法被GC回收。
- 这是一个 过程,是问题的根源。
- 结果:内存溢出(OutOfMemoryError)
- 内存泄漏的持续积累(或其他原因,如一次性加载过多数据),导致JVM的堆内存被耗尽。
- 当JVM无法再分配所需内存时,就会抛出
OutOfMemoryError: Java heap space。 - 这是一个 事件,是问题的最终表现。
- 范畴:OOM
- OOM是包含内存溢出在内的一个更广泛的概念。
关系图:代码缺陷(如未释放引用) → 内存泄漏(对象堆积) → JVM堆内存耗尽 → 内存溢出(抛出OutOfMemoryError)
如何排查内存泄漏?
- 启用GC日志: 使用JVM参数
-XX:+PrintGCDetails -Xloggc:<file-path>观察GC行为。如果看到Full GC越来越频繁,且每次回收后老年代可用内存越来越少,基本可以断定有内存泄漏。 - 使用分析工具:
- JConsole / JVisualVM: 实时监控堆内存使用情况,观察内存曲线是否呈“锯齿向上”的趋势。
- 生成堆转储(Heap Dump): 在OOM时自动生成(
-XX:+HeapDumpOnOutOfMemoryError)或使用工具手动生成。 - 使用专业工具分析堆转储: 如 Eclipse Memory Analyzer Tool (MAT)。MAT可以精确定位到是哪个类的哪个对象占用了最大内存,以及是什么GC Roots在引用它们,这是定位内存泄漏的“杀手锏”。
总结:内存泄漏是病根,Java内存溢出是病症。 作为一名Java开发者,我们的主要工作就是通过代码审查、测试和工具分析,找到并根除内存泄漏这个“病根”,从而避免内存溢出这个“病症”的发生。
Q:主流 MQ 的区别
为了帮助你在项目中选择合适的消息队列,下面这个表格从多个核心维度梳理了目前几款主流消息队列的主要区别。
| 特性维度 | Kafka | RocketMQ | RabbitMQ | ActiveMQ |
|---|---|---|---|---|
| 核心定位 | 高吞吐的分布式流处理平台 | 兼具高性能与事务能力的全能型选手 | 灵活、易用的消息代理 | 功能丰富的传统消息中间件 |
| 吞吐量 | ⭐⭐⭐⭐⭐ 极高 (百万级/秒) | ⭐⭐⭐⭐ 高 (十万级/秒) | ⭐⭐⭐ 中 (万级/秒) | ⭐⭐ 中低 (万级/秒) |
| 消息可靠性 | 非常高(通过副本机制保证) | 非常高(基于事务保证) | 最高(AMQP协议保证) | 有较低概率丢失数据 |
| 消息顺序性 | 单分区内有序 | 单队列(queue)内有序 | 单队列内有序(需避免使用高级功能) | 支持 |
| 延迟 | 毫秒级 | 毫秒级 | 微秒级 | 毫秒级 |
| 主要优势 | 极致吞吐、生态完善、堆积能力强 | 高性能、强事务消息、顺序消息 | 灵活的路由、低延迟、多协议支持 | 功能完备、支持多种协议 |
| 典型场景 | 日志采集、流式数据处理、实时数据管道 | 电商交易、金融业务、分布式事务 | 企业级应用、复杂路由、实时通信 | 中小型企业业务系统、多协议集成 |
💡 各款消息队列的深入解析
在表格的基础上,以下是关于这几款消息队列更详细的解读,以帮助你进一步理解它们的特性。
- Apache Kafka Kafka专为高吞吐和大规模实时数据流处理而设计。它采用分区和副本机制,非常适合日志采集、监控数据和构建实时数据管道等场景。不过,它的运维相对复杂,且默认配置下延迟相对较高。
- Apache RocketMQ RocketMQ在高吞吐和低延迟之间取得了很好的平衡,并原生支持分布式事务消息。在电商、金融等对数据一致性要求极高的业务场景(如秒杀、订单处理)中表现出色。其架构源自阿里,经历过"双十一"等超大规模流量考验。
- RabbitMQ 基于AMQP协议,RabbitMQ的核心优势在于其强大的消息路由能力和极低的延迟。通过交换机、绑定键和队列的组合,可以实现非常灵活的消息分发逻辑。它部署简单,文档完善,非常适合业务逻辑复杂但吞吐量要求不是极端的中小型项目。
- ActiveMQ 作为一款老牌的消息中间件,ActiveMQ对JMS规范支持完善,并支持多种协议。其功能全面,但性能上限相对较低,在高并发、高吞吐场景下可能成为瓶颈,且社区活跃度相对不如前三者。
🎯 如何根据场景选择
没有最好的消息队列,只有最合适的。你可以根据以下思路进行选择:
- 选择 Kafka:当你的首要任务是处理海量数据(如日志、指标、用户行为流),并且需要极高的吞吐量用于实时计算或流处理时,Kafka是业内标准。
- 选择 RocketMQ:如果你的业务处于金融、电商等领域,需要同时应对高并发流量和保证分布式事务(如下单扣库存)的强一致性,RocketMQ是更优的选择。
- 选择 RabbitMQ:当你的业务需要复杂的消息路由(如根据不同规则分发消息),或者对响应延迟非常敏感(如实时通知),且总吞吐量在十万级以下时,RabbitMQ非常合适。
- 选择 ActiveMQ:在中小型企业的系统中,需要进行多协议集成或对JMS有强依赖,且对性能要求不极致的场景下,可以考虑使用ActiveMQ。
希望这份详细的分析能帮助你做出明智的选择。如果你的项目有更具体的技术指标或业务场景,我很乐意提供更具针对性的分析。
面经三:紫川软件 - 平安产险
Q:Redis 如何保证缓存数据一致性?
好的,这是一个非常核心的面试题和实际问题。Redis 作为缓存,其核心目的是为了提升性能,但随之而来的就是与底层数据库(如 MySQL)的数据一致性问题。
首先,要明确一个核心观点:在分布式系统下,无法做到绝对的、实时的缓存数据一致性,我们追求的是最终一致性。 我们的目标是尽可能缩短不一致的时间窗口,并保证数据最终是正确的。
下面我们来详细讲解几种主流的保证缓存数据一致性的方案,从常见到最优。
1. 缓存更新策略
这是最基础的决策,即何时、如何更新缓存和数据库。
1.1 Cache-Aside (旁路缓存策略)
这是最常用、最经典的策略。应用代码直接负责与缓存和数据库交互。
- 读流程 (Lazy Loading):
- 接收读请求。
- 首先查询 Redis 缓存。
- 如果缓存命中,直接返回数据。
- 如果缓存未命中,则查询数据库。
- 将数据库查询的结果写入 Redis 缓存,然后返回数据。
- 写流程:
- 接收写请求。
- 更新数据库。
- 删除 Redis 中的缓存数据。
为什么是删除缓存,而不是更新缓存? 这是关键点!如果采用更新缓存,在并发写场景下可能会出现数据不一致。
- 场景:线程 A 和线程 B 按顺序更新同一条数据。
- 线程 A 更新数据库 (value=1)
- 线程 B 更新数据库 (value=2)
- 线程 B 更新缓存 (value=2)
- 线程 A 更新缓存 (value=1) // 此时缓存中是旧数据1,与数据库的新数据2不一致。
- 删除缓存可以避免这个问题,它使缓存失效,下次读取时自然会从数据库加载最新值。
优点:简单、高效,是业界最通用的方案。 缺点:在特定并发场景下,仍会出现短时间的不一致。
2. 应对并发场景的进阶方案
Cache-Aside 策略在并发读写时,可能会因为执行顺序问题导致不一致。
场景:先删缓存,后更新数据库 (并发读写)
- 线程 A (写):
- 删除缓存。
- (此时,由于网络或CPU调度,A暂停)
- 线程 B (读):
- 发现缓存不存在。
- 从数据库读取旧值。
- 将旧值写入缓存。
- 线程 A (写):
- 更新数据库为新值。
结果:缓存中是被线程B写入的旧值,数据库是新值,发生了不一致。
解决方案 1:延迟双删
为了解决上述问题,可以在更新数据库后,再执行一次缓存删除,并给予一定的延迟。
- 删除缓存。
- 更新数据库。
- 睡眠一段时间 (如 500ms - 1s,具体时间需要根据业务读写耗时评估)。
- 再次删除缓存。
第二次删除的目的是为了清除在“更新数据库”这个时间窗口内,可能被其他读请求加载到缓存中的旧数据。 睡眠是为了确保读请求已经完成了“读数据库 -> 写旧数据到缓存”这个操作。
优点:通过增加一次删除操作,大大降低了不一致的概率。 缺点:不优雅,需要预估延迟时间,降低了吞吐量。
解决方案 2:异步重试(推荐)
核心思想是:将第二次删除操作通过异步消息的方式执行,确保它最终能成功。
a. 使用消息队列
- 应用服务在更新数据库后,向消息队列发送一条删除缓存的消息。
- 一个独立的消费者服务消费该消息,执行删除缓存的操作。
- 如果删除失败,消息会被重试,直到成功。
b. 利用数据库 Binlog(最优解) 这是大型互联网公司最常用的方案,将缓存层完全作为数据库的从库。
- 应用服务:更新数据库。
- 一个独立的中间件(如 Canal、Debezium)订阅数据库的 Binlog(二进制日志,记录了所有数据变更)。
- 中间件解析 Binlog,获取变更的数据和操作。
- 中间件根据变更,调用 Redis 的接口删除或更新对应的缓存。
优点:
- 彻底解耦:应用服务只关心写数据库,完全不知道缓存的存在。
- 保证最终一致性:只要数据库更新了,Binlog 就能被解析,缓存最终会被删除。
- 高性能:对主业务链路无侵入。
缺点:架构复杂,需要维护额外的中间件。
3. 其他缓存策略
除了 Cache-Aside,还有一些其他策略,但各有适用场景。
3.1 Write-Through (穿透写)
应用服务将缓存作为主要数据存储。写操作时:
- 先更新缓存。
- 缓存组件自己负责将数据同步到数据库。
优点:能保证缓存和数据库的强一致性。 缺点:写延迟高,因为需要等待两个写操作都完成。对缓存稳定性要求极高。
3.2 Write-Behind (异步写)
Write-Through 的异步版本。写操作时:
- 只更新缓存。
- 缓存组件在后台异步、批量地将数据更新到数据库。
优点:写性能极高。 缺点:有数据丢失风险(缓存宕机),只能保证最终一致性。
总结与最佳实践
| 方案 | 操作顺序 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|---|
| Cache-Aside | 读:缓存->DB->回填 写:更新DB->删除缓存 | 简单、通用 | 并发下有短时不一致风险 | 绝大多数业务场景 |
| 延迟双删 | 删除缓存->更新DB->睡眠->再删缓存 | 降低不一致概率 | 不优雅,需估时,性能差 | 对一致性要求稍高,且无法引入复杂架构的场景 |
| 异步重试 (MQ) | 更新DB->发MQ->消费者删缓存 | 解耦,保证最终一致 | 架构稍复杂,需维护MQ | 中大型项目,对一致性要求高 |
| 订阅 Binlog | 更新DB->中间件解析Binlog->删缓存 | 彻底解耦,强保证 | 架构复杂,技术门槛高 | 大型、高并发项目的最佳实践 |
| Write-Through | 更新缓存->缓存同步更新DB | 强一致性 | 写性能差,缓存依赖重 | 缓存即数据库的场景,较少用 |
给出现代架构下的通用建议:
- 首选基础方案:对于大多数应用,使用 Cache-Aside + 删除缓存 就已经足够。可以容忍极短时间(毫秒级)的不一致。
- 升级到可靠方案:如果对一致性要求很高,并且团队有技术能力,强烈推荐使用「订阅数据库 Binlog」 的方案。这是目前最可靠、最优雅的解决方案。
- 设置缓存过期时间:无论使用哪种方案,都务必给缓存数据设置一个合理的过期时间 (TTL)。这是一个兜底方案,即使同步逻辑出现问题,缓存最终也会自动失效,从数据库加载最新数据,保证最终一致性。
- 避免复杂逻辑:尽量避免“更新缓存”的逻辑,坚持使用“删除缓存”,让下一次读请求来触发缓存重建,这样逻辑更简单,更不容易出错。
简单来说,“更新数据库,删除缓存”是基础,而“通过 Binlog 异步删除缓存”是追求极致一致性的终极答案。
Q:项目中优化日志打印大对象的具体实现
核心问题阐述
首先,一句话点明问题的严重性:
"在项目中,我们遇到一个典型的性能陷阱:在DEBUG或INFO级别日志中,直接打印了完整的大对象(如包含几十个字段的供应商对象、查询结果列表等)。 这带来了三个严重后果:
- 日志磁盘爆炸:单条日志可能达到几百KB甚至几MB,迅速写满磁盘。
- CPU资源耗尽:序列化大对象为字符串的
toString()方法非常消耗CPU。- 最危险的:可能诱发OOM。尤其是在使用异步日志框架(如Logback的AsyncAppender)时,如果日志生产速度超过消费速度,大量待写日志的大对象会堆积在内存队列中,直接导致内存溢出。"
具体实现方案(分层讲解)
你可以按照从"最简单"到"最优雅"的顺序来介绍你的解决方案,这能体现你思考的层次。
方案一:最直接的方法 - 重写 toString() 方法
做法: 禁止在实体类中使用Lombok的@Data注解自动生成toString(),而是手动重写,只包含核心ID和名称等关键字段。
示例代码对比:
// 【优化前 - 危险的写法】
@Data
public class Supplier {
    private Long id;
    private String name;
    private String address;
    // ... 还有30多个字段
    private List<ContactPerson> contactList; // 关联对象,更大!
}

// 打印日志:log.debug("Processing supplier: {}", supplier);
// 输出:Supplier(id=1, name=XX公司, address=XX路..., contactList=[...]) // 巨大!

// 【优化后 - 安全的写法】
@Data
public class Supplier {
    private Long id;
    private String name;
    private String address;
    // ... 其他字段

    @Override
    public String toString() {
        return "Supplier{" +
                "id=" + id +
                ", name='" + name + '\'' +
                '}'; // 只打印核心标识字段
    }
}
评价:
"这是最基础、最快速的修复方式,能立即解决大部分问题。但它的缺点是侵入性强,需要在每个实体类中手动维护,而且团队开发中容易遗漏。"
方案二:更优雅的方法 - 使用自定义工具类与注解
做法: 创建一个LogUtil工具类,利用反射或预定义的规则,在需要打印日志时,动态生成一个只包含关键信息的"安全视图"对象。
示例代码:
// 1. 定义一个注解,标记需要日志打印的字段
@Target(ElementType.FIELD)
@Retention(RetentionPolicy.RUNTIME)
public @interface LogField {
}

// 2. 在实体类中标记
@Data
public class Supplier {
    @LogField
    private Long id;
    @LogField
    private String name;
    private String address; // 这个不会被打印
    // ...
}

// 3. 创建日志工具类
public class LogUtil {
    public static Object toSafeLogObject(Object obj) {
        if (obj == null) {
            return null;
        }
        // 这里可以通过反射读取@LogField注解,构建一个Map或JSON字符串
        // 或者简单点:如果是集合,只返回大小;如果是大对象,返回其ID。
        if (obj instanceof Collection) {
            return "Collection(size=" + ((Collection) obj).size() + ")";
        }
        if (obj instanceof BaseEntity) { // 假设你的实体有统一基类
            return obj.getClass().getSimpleName() + "(id=" + ((BaseEntity) obj).getId() + ")";
        }
        // 对于其他复杂对象,调用其安全的toString()
        return obj.toString();
    }
}

// 4. 使用方式
log.debug("Processing supplier: {}", LogUtil.toSafeLogObject(supplier));
// 输出:Processing supplier: Supplier(id=1, name=XX公司)
评价:
"这种方式更加优雅和集中,将日志安全的逻辑收敛到了一处,降低了业务代码的侵入性。我们可以根据不同类型对象定制化其’安全视图’。"
方案三:最根本的方法 - 使用日志占位符并前置判断
做法: 在打印DEBUG/TRACE等低级别日志前,先使用isDebugEnabled()进行判断,避免不必要的字符串拼接和对象序列化。
示例代码:
// 【优化前 - 即使日志级别为ERROR,这行代码也会执行toString()】
log.debug("Processing supplier: {}", supplier);

// 【优化后 - 只有启用DEBUG时,才会进行参数计算】
if (log.isDebugEnabled()) {
    log.debug("Processing supplier: {}", LogUtil.toSafeLogObject(supplier));
}
评价:
"这是性能最高的写法。它从根本上避免了在不需要日志时,任何不必要的计算开销。我们将其作为代码规范在团队中推广,并结合前面的
LogUtil,形成了最佳实践。"
面试完整话术模板
你可以这样连贯地讲述:
"在采购服务项目中,我们曾遇到一个由日志打印大对象引发的严重性能问题。直接打印完整的供应商或评估模板对象,会导致单条日志过大,不仅撑爆磁盘、消耗CPU,更危险的是可能压垮异步日志框架的内存队列,导致OOM。
我的优化是分三步走的:
- 首先,我制定了代码规范,禁止使用Lombok的默认
toString(),要求所有实体类重写该方法,只输出核心ID和名称。- 其次,为了更优雅地统一处理,我设计了一个
LogUtil工具类。它利用反射和自定义注解,能够为任何对象生成一个只包含关键信息的’安全视图’,从根本上避免了敏感数据和超大对象的输出。- 最后,结合性能最佳实践,我们要求在打印DEBUG/TRACE日志前,必须使用
isDebugEnabled()进行判断,避免不必要的日志对象构建开销。通过这些组合措施,我们将单条日志的平均大小降低了90%以上,并且再未发生过因日志打印导致的内存或CPU问题,系统的稳定性和可观测性都得到了显著提升。"
这样回答,你不仅给出了解决方案,还体现了你从问题识别 -> 临时修复 -> 架构优化 -> 规范建立的完整系统性思考能力,非常加分。
面经四:软通 - 华为项目
Q:CAS 中 ABA 问题
1. 什么是 CAS ?
在深入ABA问题之前,我们必须先理解CAS本身。
CAS(Compare-And-Swap) 是一种无锁编程的核心原子操作。它用于实现多线程环境下的同步,而无需使用传统的互斥锁。
一个CAS操作包含三个操作数:
- 内存位置(V)
- 期望的原始值(A)
- 新值(B)
CAS的操作逻辑是:
“我认为内存位置V的值应该是A。如果是,那么请将V的值更新为B;否则,不要修改它,但要告诉我当前的实际值是什么。”
这个操作是作为一条单独的原子指令由CPU提供的(例如,在x86架构上是 CMPXCHG 指令)。这意味着在整个比较和交换的过程中,不会有其他线程插入来修改这个内存值。
CAS的典型应用:
- 实现原子类(如
java.util.concurrent.atomic包下的AtomicInteger)。 - 实现自旋锁。
- 实现无锁数据结构(如队列、栈)。
2. ABA 问题的定义与产生场景
ABA问题是CAS操作中一个经典且隐蔽的陷阱。
定义: ABA问题是指,一个线程在执行CAS操作时,发现内存位置V的值确实是它期望的A,于是它认为这个值没有被修改过,并成功地将它更新为B。然而,在它读取A和进行CAS操作的这段时间内,内存值可能已经经历了一个变化循环:从A变为B,然后又变回A。
这个“A -> ? -> A”的过程,使得第一个线程的CAS操作在逻辑上变得不再安全,因为它所基于的假设(“值没变,所以状态也没变”)是错误的。
一个生动的比喻(栈的ABA问题)
假设有一个无锁栈,栈顶元素是 A。
- 线程1 准备执行一个出栈操作。它读取到栈顶为
A,然后它被操作系统挂起。- 线程1的期望值:
A - 线程1想要做:将栈顶从
A设置为A.next(假设为null)。
- 线程1的期望值:
- 线程2 在此期间开始运行并执行了一系列操作:
- 步骤1(A->B): 线程2执行出栈,成功将栈顶从
A改为B。 - 步骤2(B->A): 线程2又执行入栈,将
A再次压入栈中。此时栈顶又变回了A。注意:虽然栈顶的值还是A,但整个栈的状态已经发生了变化! 比如,A.next可能已经不再是之前的null,或者栈中的其他元素已经变了。
- 步骤1(A->B): 线程2执行出栈,成功将栈顶从
- 线程1 恢复运行,开始执行CAS操作。它检查栈顶:“嗯,还是
A,和我离开时一样”。于是CAS成功,将栈顶设置为A.next(即null)。
结果: 线程2入栈的 A 被线程1的CAS操作无情地丢弃了,栈顶直接变成了 null。这导致数据丢失,破坏了栈的完整性。
3. ABA问题的根本原因与危害
根本原因: CAS操作只关注值的相等性,而忽略了状态的变化历史。它无法感知到值在中间过程中是否发生过变化。
危害:
- 数据不一致: 如上例所示,会导致数据丢失或数据结构被破坏。
- 逻辑错误: 程序的业务逻辑可能依赖于“值未被改变”这一强假设。ABA的发生使得这个假设不成立,从而导致难以复现和调试的逻辑错误。
- 隐蔽性强: ABA问题在高并发场景下发生的概率相对较低,且难以通过常规测试发现,通常需要在极大压力下长时间运行才会暴露,因此非常危险。
4. 解决方案
解决ABA问题的核心思想是:让CAS操作不仅关心值,还要关心版本号或状态标识。
方案1:原子引用+版本号(Stamp)
这是最常用、最经典的解决方案。
原理: 不再仅仅比较一个值,而是比较一个 (值, 版本号) 对。每次更新值,版本号都递增(或改变)。这样,即使值从A变回A,版本号也早已不同。
在Java中,可以使用 AtomicStampedReference<V> 类。
import java.util.concurrent.atomic.AtomicStampedReference;

public class ABASolution {
    private static AtomicStampedReference<String> atomicStampedRef =
            new AtomicStampedReference<>("A", 0); // 初始值"A",初始版本号0

    public static void main(String[] args) throws InterruptedException {
        String initialRef = atomicStampedRef.getReference();
        int initialStamp = atomicStampedRef.getStamp();

        // 线程1:模拟ABA场景
        Thread t1 = new Thread(() -> {
            try {
                // 模拟线程1在读取后暂停
                Thread.sleep(1000);
            } catch (InterruptedException e) {
                e.printStackTrace();
            }
            // 尝试CAS,期望值是"A",期望版本号是0,新值是"B",新版本号是1
            boolean success = atomicStampedRef.compareAndSet(
                "A", "B", initialStamp, initialStamp + 1);
            System.out.println("Thread 1 CAS: " + success); // 输出 false! 因为版本号变了
        });

        // 线程2:执行 A -> B -> A 的操作,并修改版本号
        Thread t2 = new Thread(() -> {
            // A -> B,版本号 0 -> 1
            atomicStampedRef.compareAndSet("A", "B", initialStamp, initialStamp + 1);
            System.out.println("Thread 2: A -> B. Stamp: " + atomicStampedRef.getStamp());

            // B -> A,版本号 1 -> 2
            atomicStampedRef.compareAndSet("B", "A", atomicStampedRef.getStamp(), atomicStampedRef.getStamp() + 1);
            System.out.println("Thread 2: B -> A. Stamp: " + atomicStampedRef.getStamp());
        });

        t1.start();
        t2.start();
        t1.join();
        t2.join();
    }
}
方案2:原子标记引用(AtomicMarkableReference)
这个方案是版本号的一个简化版。它不使用数字版本号,而是使用一个 boolean 标记位。每次修改时,翻转这个标记位。
它适用于“这个值是否被修改过”这种二元状态判断,不如版本号精确,但开销更小。
方案3:使用具有唯一性的对象
确保要CAS的引用指向的对象是“一次性”的。一旦被修改,就创建一个新的对象,而不是复用旧对象。
例如,在上面的栈例子中,我们可以规定每次入栈的节点都必须是新创建的 Node 对象。这样,即使线程2将 A 再次入栈,它也是一个新的 Node 实例(内存地址不同),线程1在CAS时发现期望的引用(旧的A对象地址)和当前栈顶的引用(新的A对象地址)不同,CAS就会失败。
在Java中,可以使用 AtomicReference<V>,但必须保证不重用对象。
总结
| 方面 | 描述 |
|---|---|
| 问题本质 | CAS只校验值的同一性,不校验状态的连续性。 |
| 产生条件 | 一个值被改为其他值后又改回原值。 |
| 核心危害 | 导致数据结构的完整性和业务逻辑的正确性被破坏,且问题隐蔽。 |
| 解决方案 | 引入版本号(AtomicStampedReference)或唯一标识,让CAS从“比较值”升级为“比较状态”。 |
在实际开发中,如果您的应用场景存在值被循环修改的可能,并且状态的连续性对业务逻辑至关重要,那么必须使用带版本号的原子引用来规避ABA问题。对于简单的计数器等场景,普通的CAS操作通常是安全的。
Q:在项目中有用到线程池吗,如果有,如何应用线程池?
当然有使用,线程池是这类企业级系统中提升性能的核心组件。下面我将详细说明在项目中如何专业地应用线程池。
线程池在项目中的核心应用场景
1. Excel数据导入 - 主要应用场景
这是你职责中明确提到的,也是线程池最经典的应用。
问题背景:
- 需要导入的零部件数据可能包含数万行
- 每行数据需要:数据校验 → 格式转换 → 业务规则验证 → 数据库写入
- 单线程串行处理需要5分钟以上,用户体验极差
线程池解决方案:
// 1. 创建专用的线程池
@Bean("excelImportExecutor")
public ThreadPoolTaskExecutor excelImportExecutor() {
    ThreadPoolTaskExecutor executor = new ThreadPoolTaskExecutor();
    executor.setCorePoolSize(5);     // 核心线程数
    executor.setMaxPoolSize(10);     // 最大线程数
    executor.setQueueCapacity(100);  // 队列容量
    executor.setThreadNamePrefix("excel-import-"); // 线程名前缀,便于监控
    executor.setRejectedExecutionHandler(new ThreadPoolExecutor.CallerRunsPolicy()); // 拒绝策略
    executor.initialize();
    return executor;
}

// 2. 使用CompletableFuture进行并行处理
public void importParts(List<PartData> partDataList) {
    // 将大数据列表拆分成小批次(如每批100条)
    List<List<PartData>> batches = Lists.partition(partDataList, 100);

    // 为每个批次创建异步任务
    List<CompletableFuture<Void>> futures = batches.stream()
        .map(batch -> CompletableFuture.runAsync(() -> {
            processBatch(batch); // 处理单个批次
        }, excelImportExecutor)) // 指定使用自定义线程池
        .collect(Collectors.toList());

    // 等待所有任务完成
    CompletableFuture.allOf(futures.toArray(new CompletableFuture[0])).join();
}
技术要点:
- 分批处理:避免创建过多线程,控制资源消耗
- 使用
CallerRunsPolicy:当队列满时,由调用线程执行,保证任务不丢失 - 线程命名:便于在日志和监控中定位问题
2. 供应商报价超时检查 - 异步任务调度
虽然你用了RabbitMQ的延时队列,但线程池也可以用于类似的周期性检查任务。
// 使用Spring的@Scheduled和线程池执行定时任务
@Scheduled(fixedRate = 300000) // 每5分钟执行一次
public void checkQuoteTimeout() {
    // 查询即将超时的报价单
    List<Quote> expiringQuotes = quoteService.findExpiringQuotes();

    // 使用线程池并行处理超时逻辑
    expiringQuotes.stream()
        .forEach(quote -> CompletableFuture.runAsync(() -> {
            quoteTimeoutService.processTimeout(quote);
        }, taskExecutor));
}
3. 数据导出与报表生成
与导入类似,大数据量的Excel导出也需要并行处理。
public CompletableFuture<ExportResult> exportQuotationReport(ExportRequest request) {
    return CompletableFuture.supplyAsync(() -> {
        // 1. 查询数据
        List<QuoteData> data = quoteRepository.findByCriteria(request);
        // 2. 生成Excel文件
        return excelGenerator.generateReport(data);
    }, reportExportExecutor); // 使用专门的报表导出线程池
}
4. 外部系统数据同步
与PDT系统、物流系统等的数据同步可以使用线程池实现异步非阻塞调用。
public void syncPartDataToLogisticsSystem(Long partId) {
    CompletableFuture.runAsync(() -> {
        try {
            logisticsSystemClient.syncPartInfo(partId);
        } catch (Exception e) {
            log.error("同步零件数据到物流系统失败, partId: {}", partId, e);
            // 记录失败,后续重试
            retryService.recordSyncFailure(partId, "LOGISTICS");
        }
    }, externalSyncExecutor);
}
线程池配置的考量因素
为什么需要自定义线程池而不是使用默认的?
- 资源隔离:
excel-import:CPU密集型,线程数 ≈ CPU核心数external-sync:IO密集型,线程数可以更多report-export:内存密集型,需要限制并发数
- 避免相互影响:
- 一个耗时的Excel导入任务不应该阻塞紧急的价格计算请求
- 通过不同的线程池实现业务隔离
典型配置示例:
# application.yml
async:
  task:
    execution:
      excel-import:
        core-pool-size: 4
        max-pool-size: 8
        queue-capacity: 50
      external-sync:
        core-pool-size: 10
        max-pool-size: 20
        queue-capacity: 100
      report-export:
        core-pool-size: 2
        max-pool-size: 4
        queue-capacity: 10
面试回答话术
你可以这样专业地阐述:
"在线程池的应用上,我们主要围绕性能瓶颈的并行化和异步化处理两个目标。
最典型的案例就是您看到的Excel导入优化。 之前单线程处理数万行数据需要5分钟,我通过:
- 自定义线程池,根据服务器CPU核心数和任务特性配置合适的参数。
- 采用 CompletableFuture + 分批处理 的模式,将大数据列表拆分成小批次并行处理。
- 为不同业务场景配置隔离的线程池,比如Excel导入、外部系统同步、报表生成都有各自的线程池,避免相互阻塞。
通过这套方案,我们将导入时间从5分钟优化到了10秒内,并且通过合理的拒绝策略和线程池监控,保证了系统在高并发导入时的稳定性。
此外,在供应商报价超时检查、大数据报表导出等场景也都广泛应用了线程池技术,实现了系统性能的全面提升。"
这样回答既体现了你的技术深度(线程池参数调优、资源隔离),又展示了业务价值(性能提升数据),还体现了系统设计思维(不同场景的不同策略),是一个全面而专业的回答。
Q:索引失效与最左前缀匹配原则
Q:联合索引(ABC,A 等于,B大于,C等于)是否用到了索引?
面经五:欧肯信息科技 - 香港项目
Q:ArrayList 与 LinkedList 的区别
Q:Spring IOC 原理
Q:Spring MVC 如何进行异常处理?
Q:如何保证幂等性?
Q:CompletableFuture 在项目中如何实现?
Q:CompletableFuture 中如何处理异常?
Q: Java 8的新垃圾回收器对比之前有什么大的变化?
面经六:京北方 - 珠海工行
Q:项目问到并发导入数据最后出现异常如何处理?
异常处理的核心原则
- 用户体验第一:给用户明确、友好的反馈,告知成功/失败情况。
- 数据一致性:确保数据不丢、不重、不错。
- 系统可用性:局部失败不应导致整个系统崩溃。
- 可追溯性:任何异常都必须有迹可循,便于排查。
具体异常场景与处理方案
场景一:数据导入过程中的异常
可能异常:
- 单条数据格式错误(如日期格式不对、数字解析失败)
- 业务逻辑校验失败(如供应商不存在、零件编号重复)
- 数据库约束冲突(唯一键冲突、外键不存在)
- 系统级错误(数据库连接中断、Redis超时、网络抖动)
处理策略:
- 采用 "部分成功,部分失败" 策略
- 不能因为单条记录的失败而回滚整个导入任务。
- 实现一个批量操作的"柔性事务"。
- 实现方案:
public class DataImportService {

    public ImportResult concurrentImport(List<PartData> dataList) {
        // 1. 数据预处理与分批
        List<List<PartData>> batches = Lists.partition(dataList, 100);
        List<CompletableFuture<BatchResult>> futures = new ArrayList<>();

        // 2. 为每个批次创建异步任务
        for (int i = 0; i < batches.size(); i++) {
            final int batchIndex = i;
            List<PartData> batch = batches.get(i);

            CompletableFuture<BatchResult> future = CompletableFuture.supplyAsync(() -> {
                BatchResult batchResult = new BatchResult();
                for (PartData data : batch) {
                    try {
                        // 3. 单条记录事务处理
                        processSingleRecord(data);
                        batchResult.addSuccess(data);
                    } catch (DataValidationException e) {
                        // 业务校验异常 - 记录但继续处理其他数据
                        batchResult.addFailed(data, "数据校验失败: " + e.getMessage());
                    } catch (DuplicateKeyException e) {
                        // 唯一键冲突 - 记录但继续处理
                        batchResult.addFailed(data, "数据重复: " + e.getMessage());
                    } catch (Exception e) {
                        // 系统级异常 - 记录并可能终止当前批次
                        batchResult.addFailed(data, "系统错误: " + e.getMessage());
                        log.error("处理数据异常, data: {}", data, e);
                    }
                }
                return batchResult;
            }, importExecutor);

            futures.add(future);
        }

        // 4. 汇总所有批次结果
        return aggregateResults(futures);
    }

    @Transactional(propagation = Propagation.REQUIRES_NEW) // 每条记录独立事务
    public void processSingleRecord(PartData data) {
        // 数据校验
        validateData(data);
        // 业务逻辑处理
        processBusinessLogic(data);
        // 数据持久化
        saveToDatabase(data);
    }
}
关键技术点:
@Transactional(propagation = Propagation.REQUIRES_NEW):为每条记录创建独立事务,确保单条失败不影响其他记录。- 异常分类处理:区分业务异常和系统异常,采取不同策略。
- 结果聚合:最终生成详细的导入报告。
场景二:数据导出过程中的异常
可能异常:
- 查询超时(数据量太大,SQL执行慢)
- 内存溢出(OOM,数据量超出JVM堆内存)
- 文件生成失败(磁盘空间不足、Excel格式错误)
- 网络中断(下载过程中客户端断开连接)
处理策略:
- 流式查询 + 分页生成
- 避免一次性加载所有数据到内存。
public void exportQuotationData(ExportRequest request, HttpServletResponse response) {
    String taskId = generateTaskId();
    try {
        // 1. 立即响应,异步处理
        response.setHeader("X-Task-Id", taskId);
        writeInitialResponse(response, "导出任务已开始");

        // 2. 异步执行导出
        CompletableFuture.runAsync(() -> {
            try {
                // 3. 使用游标或分页流式查询
                try (Cursor<QuotationData> cursor = quotationRepository.streamByCriteria(request)) {
                    ExcelWriter excelWriter = EasyExcel.write(getOutputStream(taskId))
                            .head(QuotationData.class)
                            .build();

                    int rowCount = 0;
                    List<QuotationData> batch = new ArrayList<>(1000);

                    for (QuotationData data : cursor) {
                        batch.add(data);
                        rowCount++;

                        // 每1000条刷新一次到磁盘,避免内存堆积
                        if (batch.size() >= 1000) {
                            excelWriter.write(batch, EasyExcel.writerSheet("报价数据").build());
                            batch.clear();
                        }

                        // 定期更新进度
                        if (rowCount % 5000 == 0) {
                            updateProgress(taskId, rowCount);
                        }
                    }

                    // 写入剩余数据
                    if (!batch.isEmpty()) {
                        excelWriter.write(batch, EasyExcel.writerSheet("报价数据").build());
                    }

                    excelWriter.finish();
                    markTaskAsCompleted(taskId, rowCount);
                }
            } catch (Exception e) {
                log.error("导出任务失败, taskId: {}", taskId, e);
                markTaskAsFailed(taskId, e.getMessage());
            }
        }, exportExecutor);

    } catch (Exception e) {
        log.error("创建导出任务失败", e);
        throw new ExportException("创建导出任务失败: " + e.getMessage());
    }
}
关键技术点:
- 异步处理:避免HTTP请求超时。
- 游标查询:使用Spring Data JPA的Streamable或MyBatis的Cursor进行流式查询。
- 分批写入:避免一次性生成超大Excel文件导致OOM。
- 进度跟踪:通过Redis或数据库记录任务状态,支持进度查询。
场景三:系统级并发异常
可能异常:
- 数据库连接池耗尽
- 死锁(多个导入任务同时操作相同资源)
- 资源竞争(多个线程同时处理相同供应商的数据)
处理策略:
- 资源隔离与限流
@Bean("importExecutor")
public ThreadPoolTaskExecutor importExecutor() {
    ThreadPoolTaskExecutor executor = new ThreadPoolTaskExecutor();
    executor.setCorePoolSize(2);  //  intentionally small
    executor.setMaxPoolSize(4);
    executor.setQueueCapacity(10);
    executor.setRejectedExecutionHandler(new ThreadPoolExecutor.CallerRunsPolicy());
    executor.setThreadNamePrefix("import-");
    return executor;
}- 分布式锁防止资源竞争
public void processSingleRecord(PartData data) {
    String lockKey = "import:supplier:" + data.getSupplierId();
    RLock lock = redissonClient.getLock(lockKey);

    try {
        // 尝试获取锁,等待5秒,锁有效期30秒
        if (lock.tryLock(5, 30, TimeUnit.SECONDS)) {
            // 处理同一供应商的数据,避免并发问题
            processSupplierData(data);
        } else {
            throw new ConcurrentAccessException("系统繁忙,请稍后重试");
        }
    } finally {
        if (lock.isHeldByCurrentThread()) {
            lock.unlock();
        }
    }
}
完整的异常处理架构
1. 统一的异常处理框架
@ControllerAdvice
public class GlobalExceptionHandler {

    @ExceptionHandler(DataImportException.class)
    public ResponseEntity<ApiResponse> handleImportException(DataImportException e) {
        // 返回结构化的错误信息
        return ResponseEntity.status(HttpStatus.BAD_REQUEST)
                .body(ApiResponse.error(e.getErrorCode(), e.getMessage(), e.getFailedRecords()));
    }

    @ExceptionHandler(ExportException.class)
    public ResponseEntity<ApiResponse> handleExportException(ExportException e) {
        return ResponseEntity.status(HttpStatus.INTERNAL_SERVER_ERROR)
                .body(ApiResponse.error("EXPORT_ERROR", e.getMessage()));
    }
}
2. 完善的监控与告警
- 通过Micrometer监控线程池状态、数据库连接池使用率
- 关键异常通过钉钉/邮件告警
- 通过ELK收集和分析异常日志
面试回答话术
你可以这样总结:
"在并发导入导出场景下,我们的异常处理是分层、分场景的:
对于导入异常,我们采用’部分成功’策略。通过为每条记录创建独立事务,结合精细的异常分类捕获,确保单条数据的失败不会影响整体导入流程,同时为用户提供详细的失败报告。
对于导出异常,核心是防患于未然。我们通过流式查询、分批写入的技术,从根本上避免了OOM和超时问题。同时采用异步任务机制,让用户能够跟踪导出进度,并在失败时获得明确反馈。
在系统层面,我们通过线程池隔离、分布式锁、限流等手段,预防并发带来的系统性风险,确保局部异常不会扩散。
这套方案让我们在面对日均数十万的导入导出请求时,仍能保证99.5%以上的任务成功率和良好的用户体验。"
这样的回答体现了你从具体技术实现到架构设计思想的全面思考,展现了处理复杂问题的能力。
Q:RabbitMQ 工作模式
1. 简单模式 / Hello World
这是最基础的模式,它甚至不需要显式地声明交换器。
- 核心组件:一个生产者、一个队列、一个消费者。
- 交换器:使用默认的匿名交换器(
"")。生产者将消息直接发送到队列。 - 路由逻辑:消息直接进入指定的队列。
- 应用场景:最简单的任务分发,一对一通信。
流程图: 生产者 —> (默认交换器) —> 队列 —> 消费者
2. 工作队列模式 / Work Queue
用于在多个消费者之间分发耗时的任务。
- 核心组件:一个生产者、一个队列、多个消费者。
- 交换器:同样使用默认交换器。
- 路由逻辑:消息进入一个队列,但由多个消费者共同处理。RabbitMQ 会以轮询 的方式将消息依次分发给不同的消费者。
- 关键特性:
- 消息确认:消费者处理完消息后必须发送一个确认信号,否则RabbitMQ会认为消息处理失败,并将其重新投递给其他消费者。
- 公平分发:可以设置
prefetch_count=1,告诉RabbitMQ一次只给一个消费者发一条消息,避免能力强的消费者空闲,而能力弱的消费者积压任务。
- 应用场景:处理图片、视频转码,发送大量邮件等耗时任务。
流程图:
           |--> 消费者1
生产者 --> 队列 --> 消费者2
           |--> 消费者3
(消息 m1, m3, m5 发给消费者1;m2, m4, m6 发给消费者2…)
3. 发布/订阅模式 / Publish/Subscribe
将一条消息广播给所有绑定到该交换器的队列。
- 核心组件:一个生产者、一个 Fanout 类型的交换器、多个队列、多个消费者。
- 交换器类型:Fanout。它会将收到的所有消息广播到所有与之绑定的队列中。
- 路由逻辑:消息发送到 Fanout 交换器,交换器将其复制并转发到每一个绑定的队列。
- 应用场景:系统广播、新闻推送、事件通知(需要让多个不同服务同时知道某个事件发生)。
流程图:
           |--> 队列1 --> 消费者1
生产者 --> (Fanout交换器) --> 队列2 --> 消费者2
           |--> 队列3 --> 消费者3
(同一条消息会被所有三个消费者收到)
4. 路由模式 / Routing
根据消息的路由键 有选择地接收消息。
- 核心组件:一个生产者、一个 Direct 类型的交换器、多个队列、多个消费者。
- 交换器类型:Direct。它会将消息的路由键 与队列和交换器绑定时使用的 绑定键 进行精确匹配。只有匹配成功,消息才会被路由到该队列。
- 路由逻辑:队列在绑定到交换器时,需要指定一个绑定键(例如:
error,info,warning)。生产者发送消息时也指定一个路由键。交换器会精确匹配这两个键。 - 应用场景:日志系统,让消费者只接收特定级别的日志(例如,一个消费者只接收
error日志,另一个接收所有日志)。
流程图:
生产者 --(消息路由键: error)--> (Direct交换器)
                               /     |     \
                      (绑定键:error) (绑定键:info) (绑定键:warning)
                            /          |           \
                    队列[错误日志]  队列[信息日志]  队列[警告日志]
                         |             |             |
                     消费者A        消费者B        消费者C
(只有消费者A会收到这条 error 消息)
5. 主题模式 / Topics
路由模式的增强版,允许使用通配符进行模糊匹配。
- 核心组件:一个生产者、一个 Topic 类型的交换器、多个队列、多个消费者。
- 交换器类型:Topic。
- 路由逻辑:
- 绑定键是一个包含通配符的字符串,用点号
.分隔。 *(星号):匹配一个单词。#(井号):匹配零个或多个单词。- 生产者发送带路由键的消息,交换器根据绑定键的模式进行匹配。
- 绑定键是一个包含通配符的字符串,用点号
- 应用场景:非常灵活的消息筛选。例如:
- 绑定键
usa.news:只接收美国新闻。 - 绑定键
usa.weather:只接收美国天气。 - 绑定键
*.news:接收所有国家的新闻。 - 绑定键
#.news:同上。 - 绑定键
usa.#:接收美国的所有消息。
- 绑定键
流程图:
生产者 --(路由键: quick.orange.rabbit)--> (Topic交换器)
                                        /       |       \
                          (绑定键: *.orange.*) (*.rabbit) (lazy.#)
                                  /             |           \
                        队列A[橙色的动物]   队列B[兔子]   队列C[懒惰的一切]
                              |               |             |
                          消费者1          消费者2       消费者3
(这条消息会匹配到 *.orange.* 和 lazy.#,所以会被投递到队列A和队列C)
6. 头部模式 / Headers
一种不依赖于路由键,而是根据消息的头部属性来路由的模式。它不常用。
- 交换器类型:Headers。
- 路由逻辑:队列在绑定时会指定一组键值对参数。生产者发送消息时,也在头部附带一组键值对。交换器会检查消息的头部是否与绑定的参数匹配。匹配规则可以是
all(全部匹配)或any(匹配任意一个)。 - 应用场景:当路由条件非常复杂,无法用简单的路由键表示时。
7. RPC 模式
严格来说,这不是一种交换器类型,而是一种应用模式。它允许客户端发送请求消息,服务端回复响应消息,实现远程过程调用。
- 核心机制:
- 客户端发送一条消息,其中包含一个唯一的
correlation_id和一个用于回复的reply_to队列名。 - 服务端处理请求,然后将结果发送到
reply_to队列,并带上相同的correlation_id。 - 客户端监听
reply_to队列,通过correlation_id来匹配响应和请求。
- 客户端发送一条消息,其中包含一个唯一的
总结对比
| 模式名称 | 交换器类型 | 路由规则 | 核心应用 |
|---|---|---|---|
| 简单模式 | (默认) | 直接指定队列 | 一对一简单通信 |
| 工作队列 | (默认) | 轮询分发 | 多消费者任务分发 |
| 发布/订阅 | Fanout | 广播 | 一对多消息广播 |
| 路由模式 | Direct | 精确匹配路由键 | 有选择性地接收消息(如日志级别) |
| 主题模式 | Topic | 通配符匹配路由键 | 灵活地、多维度地筛选消息 |
| 头部模式 | Headers | 匹配消息头属性 | 复杂条件路由(不常用) |
理解这些模式的关键在于理解交换器类型及其路由逻辑。选择哪种模式取决于你的业务场景中,消息需要如何被分发给不同的消费者。
Q:Nacos 如何监控服务宕机,分几步来对宕机的服务进行交互
好的,这是一个非常核心的微服务问题。Nacos 对服务宕机的监控和处理是一个典型的“主动探测 + 客户端心跳”模式,其交互流程可以清晰地分为几个步骤。
下面我将分两部分详细阐述:
- Nacos 如何监控服务宕机(服务发现与健康检查机制)
- 服务宕机后的交互步骤
第一部分:Nacos 如何监控服务宕机
Nacos 主要通过两种方式来检测服务实例是否存活:
1. 客户端主动上报心跳(默认模式 - AP 模式)
这是 Nacos 默认的、基于 Distro 协议的 AP 模式下的健康检查方式。
- 原理:服务实例在注册到 Nacos 后,会作为一个客户端,定期(例如每5秒)向 Nacos 服务器发送一个心跳。这个心跳本质上是一个周期性的健康报告,告诉服务器:“我还活着”。
- 关键配置:
心跳间隔:客户端发送心跳的频率。超时时间:Nacos 服务器在多久没收到心跳后,会认为该实例不健康。删除超时:在不健康状态持续多久后,直接从服务列表中删除该实例。
- 工作模式:这种方式将健康检查的压力分散到了各个客户端,服务器端主要是记录和判断,非常适合大规模集群。
2. 服务器端主动健康检查(CP 模式)
当使用 Nacos 的基于 Raft 协议的 CP 模式时,或者用户显式配置了 ephemeral=false 注册临时实例时,Nacos 服务器会主动对服务实例进行健康检查。
- 原理:Nacos 服务器会定期(例如每20秒)主动向配置好的服务实例健康检查端点(如
/health)发起请求(如 HTTP 请求或 TCP 端口探测)。 - 关键配置:
检查间隔:服务器发起检查的频率。超时时间:等待服务响应的超时时间。健康路径:健康检查的 URL 路径。
- 工作模式:这种方式由服务器主动发起,对网络和服务器的压力更大,但控制权在服务器端。
总结:在绝大多数 Spring Cloud Alibaba 等场景下,我们使用的是默认的临时实例和客户端心跳模式。因此,下面的交互步骤将基于这种模式展开。
第二部分:服务宕机后的交互步骤(基于客户端心跳模式)
假设我们有一个 UserService 实例,它已经注册到了 Nacos 服务器。现在我们模拟该实例突然宕机(如进程被杀掉)。
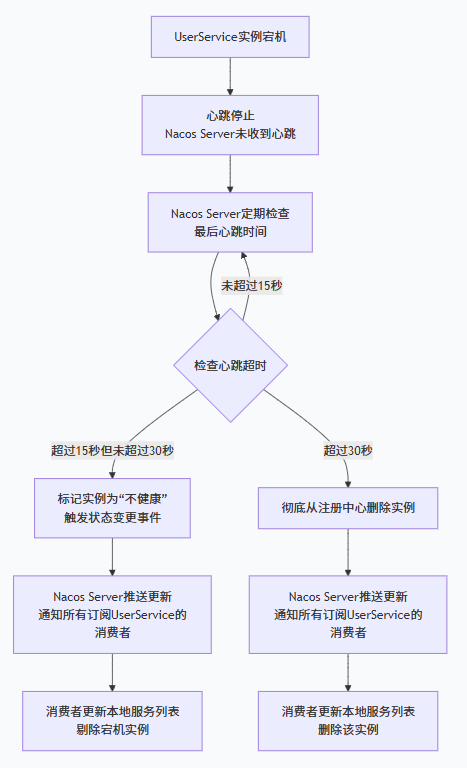
整个交互流程可以分为以下几步:
第1步:心跳停止
- 动作:UserService 实例由于宕机,停止了向 Nacos Server 发送周期性的心跳包。
- 状态:Nacos Server 的注册中心里,该实例的“最后心跳时间”停止更新。
第2步:标记为不健康
- 动作:Nacos Server 内部有一个健康检查线程,它会扫描所有实例的“最后心跳时间”。如果发现当前时间减去“最后心跳时间”超过了预设的超时时间(默认15秒),它会将该实例的健康状态设置为
false。 - 状态:在 Nacos 控制台上,你可以看到该实例的“健康实例数”减少,“不健康实例数”增加。这个实例仍然在服务列表中,但已经被标记为不健康。
第3步:服务列表更新与推送
- 动作:
- Nacos Server 意识到 UserService 的服务列表发生了变更(有实例变为不健康)。
- 推送机制:Nacos Server 会立即向所有订阅了 UserService 的消费者(如 Gateway、其他微服务)推送一条消息,通知它们服务列表已变更。
- 交互:这是一个 Server Push 模型,非常及时,消费者几乎在秒级就能感知到变化,而不需要等待下一次主动拉取。
第4步:消费者更新本地缓存
- 动作:消费者(如 OrderService)收到 Nacos Server 的推送后,会立即从服务器拉取最新的 UserService 实例列表。在拉取到的列表中,那个被标记为不健康的实例已经被过滤掉(或者消费者本地在收到列表后,会主动剔除不健康实例)。
- 结果:从此以后,OrderService 发起的对于 UserService 的负载均衡调用(如通过 Spring Cloud LoadBalancer 或 Ribbon),将不会再被路由到那个已经宕机的实例上。这就实现了服务的自动熔断和故障隔离。
第5步:彻底删除实例
- 动作:如果那个宕机的实例在接下来的一个更长的时间窗口内(删除超时时间,默认30秒)一直没有恢复心跳,Nacos Server 会最终将这个实例从注册列表中彻底删除。
- 状态:在 Nacos 控制台上,该实例会完全消失。
- 注意:删除后,同样会通过第3步的推送机制通知所有消费者。
关键配置参数(Spring Cloud Alibaba)
在你的 application.yml 中,可以通过以下配置调整这些行为:
spring:
  cloud:
    nacos:
      discovery:
        # Nacos 服务器地址
        server-addr: localhost:8848
        # 心跳间隔 (默认5秒) - 客户端->服务端
        heart-beat-interval: 5000
        # 心跳超时 (默认15秒) - 服务端判断下线
        heart-beat-timeout: 15000
        # 删除实例超时 (默认30秒) - 服务端彻底删除
        ip-delete-timeout: 30000
        # 实例是否为临时实例 (true: 用心跳, false: 用服务器端检查)
        ephemeral: true
总结
Nacos 通过 “客户端心跳 + 服务器端超时判断 + 实时推送” 这一套组合拳,高效地实现了服务宕机的监控和自动处理。其核心交互步骤可以概括为:
- 检测:通过心跳超时检测到不健康实例。
- 标记:在服务器端将其标记为不健康。
- 通知:立即推送变更给所有相关消费者。
- 隔离:消费者更新本地列表,实现流量隔离。
- 清理:最终清理长时间宕机的实例。
这套机制保证了微服务架构的高可用性和自愈能力。
Q:了节省成本,开发测试生产用的一个服务器,Nacos如何区分环境
Q:SQL 查询语句的执行顺序了解吗?
先执行 FROM 确定主表,再执行 JOIN 连接,然后 WHERE 进行过滤,接着 GROUP BY 进行分组,HAVING 过滤聚合结果,SELECT 选择最终列,ORDER BY 排序,最后 LIMIT 限制返回行数。
WHERE 先执行是为了减少数据量,HAVING 只能过滤聚合数据,ORDER BY 必须在 SELECT 之后排序最终结果,LIMIT 最后执行以减少数据传输。
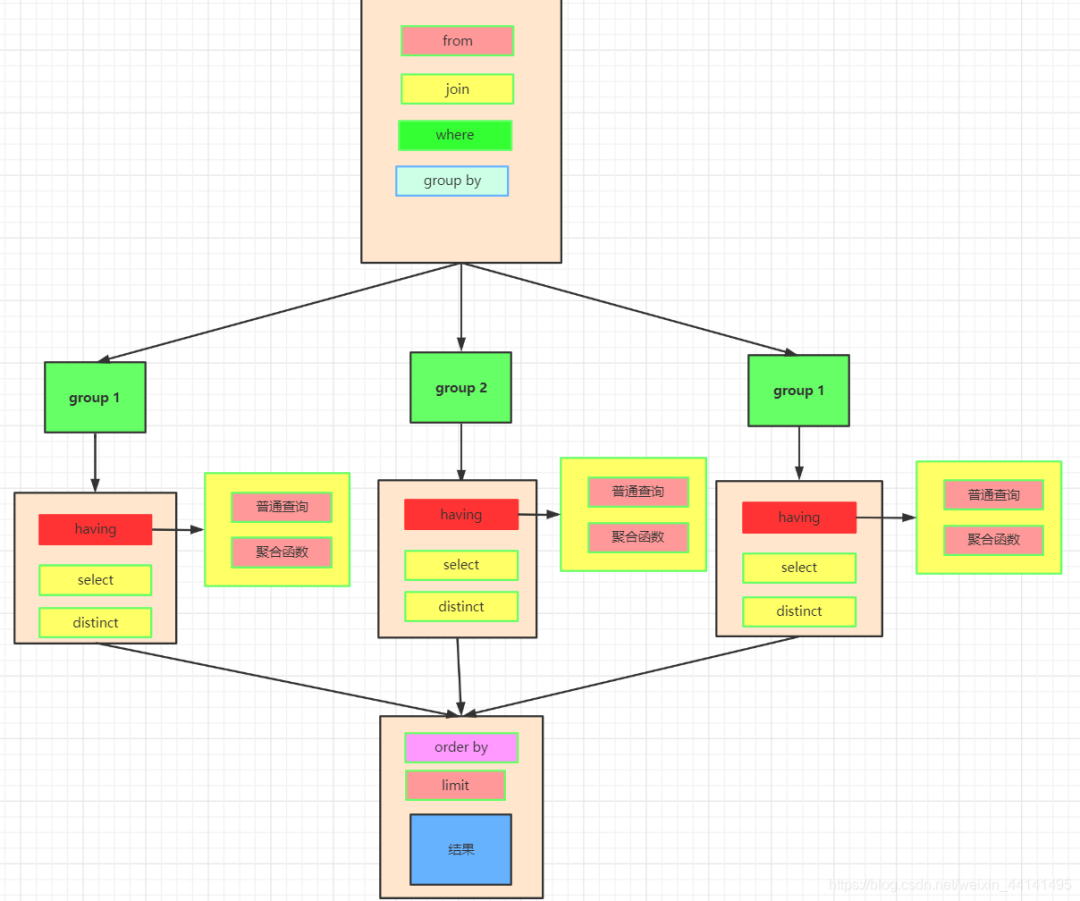
| 执行顺序 | SQL 关键字 | 作用 |
|---|---|---|
| ① | FROM | 确定主表,准备数据 |
| ② | ON | 连接多个表的条件 |
| ③ | JOIN | 执行 INNER JOIN / LEFT JOIN 等 |
| ④ | WHERE | 过滤行数据(提高效率) |
| ⑤ | GROUP BY | 进行分组 |
| ⑥ | HAVING | 过滤聚合后的数据 |
| ⑦ | SELECT | 选择最终返回的列 |
| ⑧ | DISTINCT | 进行去重 |
| ⑨ | ORDER BY | 对最终结果排序 |
| ⑩ | LIMIT | 限制返回行数 |
这个执行顺序与编写 SQL 语句的顺序不同,这也是为什么有时候在 SELECT 子句中定义的别名不能在 WHERE 子句中使用得原因,因为 WHERE 是在 SELECT 之前执行的。
LIMIT 为什么在最后执行?
因为 LIMIT 是在最终结果集上执行的,如果在 WHERE 之前执行 LIMIT,那么就会先返回所有行,然后再进行 LIMIT 限制,这样会增加数据传输的开销。
ORDER BY 为什么在 SELECT 之后执行?
因为排序需要基于最终返回的列,如果 ORDER BY 早于 SELECT 执行,计算 COUNT(*) 之类的聚合函数就会出问题。
SELECT name, COUNT(*) AS order_count
FROM orders
GROUP BY name
ORDER BY order_count DESC;
Q:Spring 事务失效场景
一、代理机制问题
1. 方法非public修饰
原因:Spring默认使用CGLIB代理,非public方法无法被代理。
@Transactional
private void privateMethod() { // 事务失效
    // ...
}解决:改为public方法。
2. 自调用(同一类内方法调用)
原因:自调用绕过代理对象,直接调用目标方法。
public void methodA() {
    methodB(); // 事务失效
}

@Transactional
public void methodB() {
    // ...
}解决:
- 注入自身代理对象:
@Autowired private MyService self; - 使用AspectJ模式(编译时织入)。
二、异常处理不当
3. 异常被捕获未抛出
原因:事务仅对未处理的RuntimeException和Error回滚(默认配置)。
@Transactional
public void method() {
    try {
        // ...
    } catch (Exception e) {
        // 未抛出异常,事务不会回滚
    }
}解决:在catch块中抛出RuntimeException或使用TransactionAspectSupport.currentTransactionStatus().setRollbackOnly()。
4. 错误配置rollbackFor
原因:默认只回滚RuntimeException和Error, checked异常不回滚。
@Transactional
public void method() throws IOException {
    throw new IOException(); // 事务不会回滚
}解决:明确指定回滚异常类型:
@Transactional(rollbackFor = Exception.class)三、事务传播行为配置错误
5. 嵌套事务传播行为不当
原因:PROPAGATION_SUPPORTS等方法在无事务时不开启新事务。
@Transactional(propagation = Propagation.SUPPORTS)
public void method() {
    // 若外部无事务,此处不会开启事务
}解决:根据业务需求选择合适的传播行为(如REQUIRED)。
四、数据库与引擎支持
6. 数据库引擎不支持事务
原因:如MySQL的MyISAM引擎不支持事务。 解决:改用InnoDB引擎。
7. 数据源未配置事务管理器
原因:未配置PlatformTransactionManager。
@Bean
public PlatformTransactionManager transactionManager(DataSource dataSource) {
    return new DataSourceTransactionManager(dataSource);
}
五、其他配置问题
8. 注解被错误覆盖
原因:子类/实现类覆盖父类方法时未添加@Transactional。
public class Parent {
    @Transactional
    public void method() { /* ... */ }
}

public class Child extends Parent {
    @Override
    public void method() { // 事务失效
        // ...
    }
}解决:在子类方法上显式添加注解。
9. 多数据源未指定事务管理器
原因:多数据源环境下未指定transactionManager。
@Transactional("specificTransactionManager")10. Spring Boot自动配置未生效
原因:排除数据源自动配置或手动配置冲突。
@SpringBootApplication(exclude = { DataSourceAutoConfiguration.class })六、排查工具与技巧
开启调试日志:
propertieslogging.level.org.springframework.transaction.interceptor=TRACE检查事务状态:
javaTransactionSynchronizationManager.isActualTransactionActive();验证代理对象:
java// 检查是否为代理对象 System.out.println(this.getClass().getName());
总结
Spring事务失效的核心原因可归纳为:
- 代理机制:非public方法、自调用。
- 异常处理:捕获未抛出、回滚配置错误。
- 配置问题:传播行为、数据源、事务管理器。
- 环境支持:数据库引擎、注解覆盖。
通过理解代理原理、合理配置事务属性及排查工具使用,可有效避免事务失效问题。
Q:缓存穿透解决方案
缓存穿透是指查询的数据在缓存中没有命中,因为数据压根不存在,所以请求会直接落到数据库上。如果这种查询非常频繁,就会给数据库造成很大的压力。
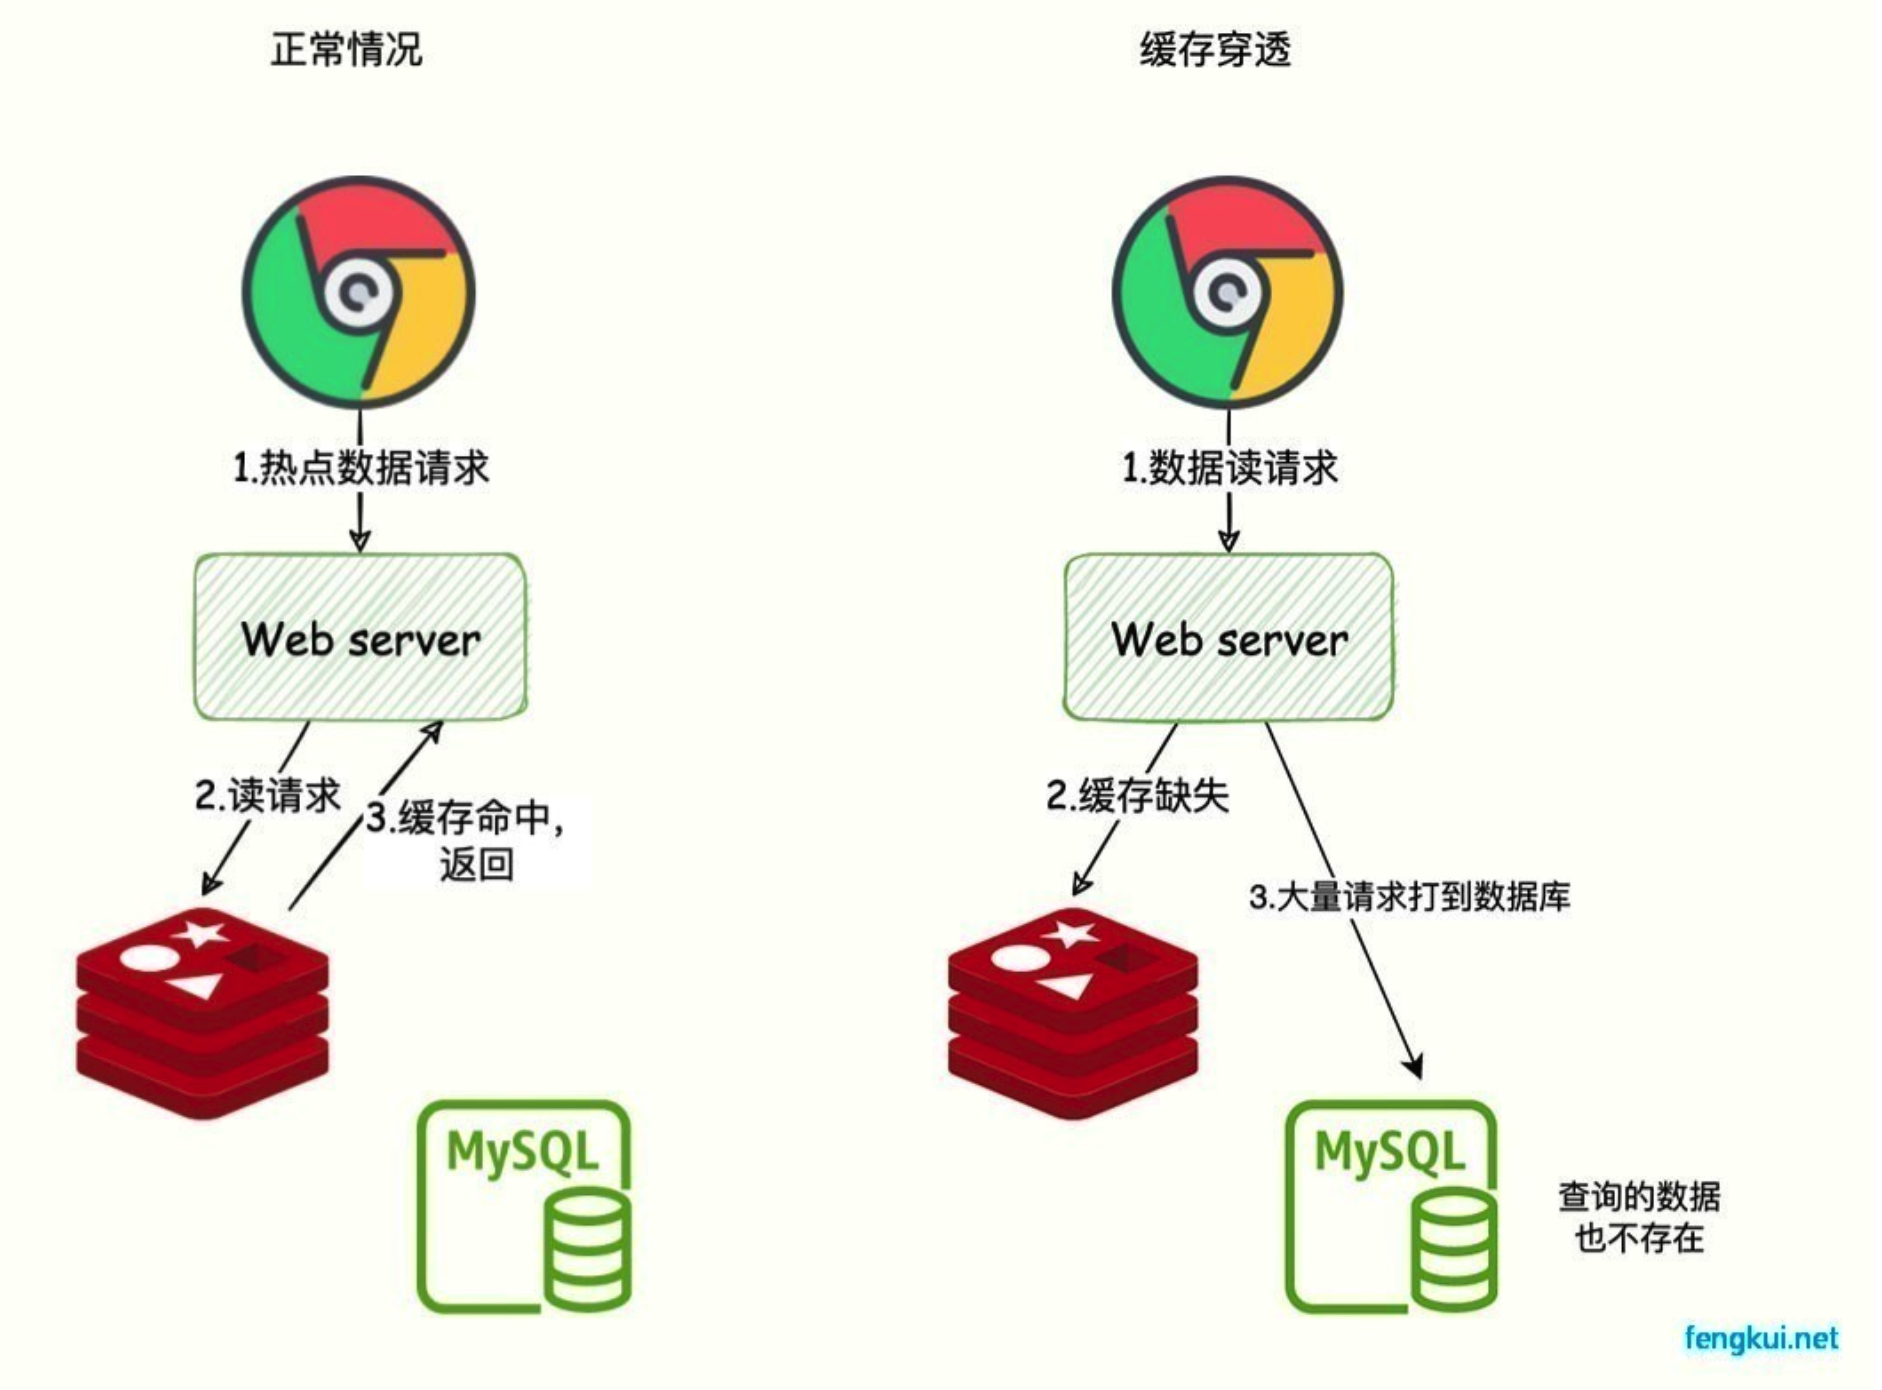
缓存击穿是因为单个热点数据缓存失效导致的,而缓存穿透是因为查询的数据不存在,原因可能是自身的业务代码有问题,或者是恶意攻击造成的,比如爬虫。
常用的解决方案有两种:第一种是布隆过滤器,它是一种空间效率很高的数据结构,可以用来判断一个元素是否在集合中。
我们可以将所有可能存在的数据哈希到布隆过滤器中,查询时先检查布隆过滤器,如果布隆过滤器认为该数据不存在,就直接返回空;否则再去查询缓存,这样就可以避免无效的缓存查询。
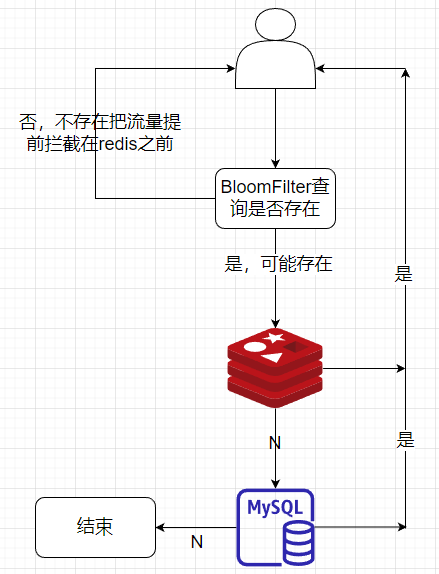
代码示例:
public String getData(String key) {
    // 缓存中不存在该key
    String cacheResult = cache.get(key);
    if (cacheResult != null) {
        return cacheResult;
    }

    // 布隆过滤器判断key是否可能存在
    if (!bloomFilter.mightContain(key)) {
        return null; // 一定不存在,直接返回
    }

    // 可能存在,查询数据库
    String dbResult = db.query(key);

    // 将结果放入缓存,包括空值
    cache.set(key, dbResult != null ? dbResult : "", expireTime);

    return dbResult;
}
布隆过滤器存在误判,即可能会认为某个数据存在,但实际上并不存在。但绝不会漏判,即如果布隆过滤器认为某个数据不存在,那它一定不存在。因此它可以有效拦截不存在的数据查询,减轻数据库压力。
第二种是缓存空值。对于不存在的数据,我们将空值写入缓存,并设置一个合理的过期时间。这样下次相同的查询就能直接从缓存返回,而不再访问数据库。
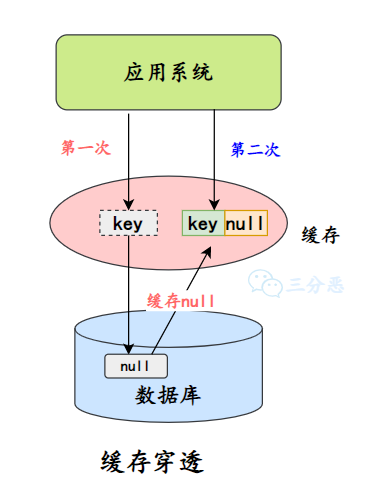
代码示例:
public String getData(String key) {
    String cacheResult = cache.get(key);

    // 缓存命中,包括空值
    if (cacheResult != null) {
        // 特殊值表示空结果
        if (cacheResult.equals("")) {
            return null;
        }
        return cacheResult;
    }

    // 缓存未命中,查询数据库
    String dbResult = db.query(key);

    // 写入缓存,空值也缓存,但设置较短的过期时间
    int expireTime = dbResult == null ? EMPTY_EXPIRE_TIME : NORMAL_EXPIRE_TIME;
    cache.set(key, dbResult != null ? dbResult : "", expireTime);

    return dbResult;
}
缓存空值的方法实现起来比较简单,但需要给空值设置一个合理的过期时间,以免数据库中新增了这些数据后,缓存仍然返回空值。
在实际的项目当中,还需要在接口层面做一些处理,比如说对参数进行校验,拦截明显不合理的请求;或者对疑似攻击的 IP 进行限流和封禁。
Q:并发调用接口仅用缓存能否做到性能优化
这是一个非常专业且深入的问题。简短回答是:仅用缓存是远远不够的,它只是性能优化体系中的一个重要环节,而不是全部。
下面我将从多个维度详细分析这个问题。
缓存能解决什么问题?(缓存的作用)
在你的零部件询报价系统中,缓存确实能在以下场景提供显著的性能提升:
- 热点数据读取
- 场景:频繁查询的零部件基础信息、供应商信息、系统配置等。
- 实现:使用Redis缓存这些数据,避免每次请求都查询数据库。
- 效果:将响应时间从几十毫秒降低到几毫秒。
- 计算结果的缓存
- 场景:复杂的报价计算、供应商评估得分、历史价格趋势分析。
- 实现:将计算结果缓存一段时间,相同参数的请求直接返回缓存结果。
- 效果:避免重复的复杂计算,极大降低CPU负载。
- 会话和状态共享
- 场景:用户登录状态、导入导出任务进度、临时表单数据。
- 实现:使用Redis存储分布式会话。
- 效果:支持应用集群部署,任何节点都能识别用户状态。
仅用缓存的局限性在哪里?
缓存主要优化的是读操作,但在高并发接口调用中,你面临的是更复杂的场景:
1. 写操作的瓶颈
- 场景:多个采购员同时为同一零件创建询价单;供应商同时报价。
- 问题:缓存无法解决数据库写竞争。即使有缓存,最终数据还是要写入数据库。高并发写会导致:
- 数据库锁竞争
- 事务冲突
- 数据不一致
2. 复杂查询的挑战
- 场景:根据多条件(零件类型、供应商地区、价格区间、交期)组合筛选询价单。
- 问题:这种查询条件千变万化,无法为所有组合建立缓存键。缓存命中率极低,压力仍然在数据库。
3. 数据一致性问题
- 场景:缓存了零件信息,但后台管理更新了该零件的基础数据。
- 问题:需要维护缓存与数据库的一致性,在分布式环境下这是个难题。如果处理不当,会返回脏数据。
4. 缓存自身成为瓶颈
- 场景:极端高并发下,大量请求访问Redis。
- 问题:
- Redis连接数不够
- 缓存击穿(热点Key失效)
- 缓存雪崩(大量Key同时失效)
- 缓存穿透(查询不存在的数据)
完整的性能优化体系(超越缓存)
基于你的项目经验,一个完整的性能优化应该包含以下层面:
1. 应用层优化(你已经做得很好的部分)
- 线程池与异步处理:使用
CompletableFuture并行处理导入任务。 - 连接池优化:配置合适的数据库连接池(HikariCP)、Redis连接池参数。
- SQL优化:分析执行计划、避免N+1查询、优化索引。
2. 数据库层优化
- 读写分离:将读请求路由到从库,写请求到主库。
- 分库分表:对大数据表(如报价历史表)按时间或业务维度拆分。
- 查询分离:将复杂查询所需的字段单独建表,避免
SELECT *。
3. 架构层优化
- 服务拆分:将系统拆分为独立的微服务(零件服务、报价服务、供应商服务),避免单点压力。
- 消息队列异步化:将非实时操作(如通知供应商、生成报表)通过MQ异步处理。
- 限流与降级:在网关层对接口进行限流,在系统压力大时降级非核心功能。
4. 缓存策略优化
- 多级缓存:
Guava Cache/Local Cache(应用层) +Redis(分布式层)。 - 缓存模式:采用
Cache-Aside模式,先读缓存,不存在则读DB并回写缓存。 - 过期策略:合理设置TTL,结合被动失效和主动更新。
具体到零部件询报价系统的优化方案
读请求优化路径:
- 请求先查询缓存
- 缓存命中直接返回
- 缓存未命中查询从库
- 回写缓存
写请求优化路径:
- 写入主库
- 使相关缓存失效
- 通过MQ异步更新衍生数据
面试专业回答话术
你可以这样回答:
"在零部件询报价系统中,缓存确实是性能优化的重要手段,但不能仅依赖缓存来解决所有并发性能问题。
缓存主要解决的是读多写少场景下的性能瓶颈,比如我们可以缓存热点零件数据、供应商信息、计算好的报价分析结果,这能显著降低数据库压力,将响应时间从数据库的几十毫秒优化到Redis的几毫秒。
但是,我们系统中有大量的写操作,比如供应商并发报价、采购员创建询价单,这些场景下缓存就无能为力了,压力最终会落到数据库上。
因此,我们建立了一个完整的性能优化体系:
- 对于读操作:采用多级缓存(Guava + Redis)和读写分离来分担压力。
- 对于写操作:通过数据库连接池优化、SQL优化、分库分表来提升写入能力,对非实时任务使用消息队列异步化。
- 对于复杂查询:采用查询分离和ES搜索引擎来应对多条件组合查询。
- 系统保护:通过线程池隔离、限流降级防止系统被突发流量冲垮。
在我的项目中,通过这套组合方案,我们在日均10万+的并发调用下,依然能保证核心接口的响应时间在200ms以内。所以,缓存是关键一环,但必须与其他优化手段协同工作。"
这样的回答既肯定了缓存的价值,又展示了你在性能优化方面的系统化思维和实战经验,会给人留下深刻的印象。
面经七:一讯牵 - 澳门项目
Q:Consul与Nacos的区别
Consul和Nacos都是现代微服务架构中非常重要的服务发现与配置管理工具,但它们在设计理念、功能侧重和生态定位上有显著区别。下面我将从多个维度进行详细对比。
核心定位与背景
- Consul
- 开发商:HashiCorp(同类产品有Vagrant, Terraform, Vault等)。
- 核心定位:服务网格(Service Mesh)和服务发现。最初以强大的多数据中心服务发现和健康检查闻名,后来通过集成Consul Connect强化了服务网格和安全通信能力。
- 设计哲学:更偏向于基础设施层,强调网络的自动化、安全与可靠性。
- Nacos
- 开发商:阿里巴巴(后开源并捐赠给Apache基金会,成为顶级项目)。
- 核心定位:动态服务发现、配置和服务管理平台。其名称源自 Naming and Configuration Service。
- 设计哲学:更偏向于应用层,致力于成为云原生应用的“一站式”解决方案,无缝支持微服务、云原生和Serverless架构。
核心功能对比
| 特性维度 | Consul | Nacos |
|---|---|---|
| 1. 服务发现 | 强项。支持基于DNS(最传统)、HTTP API和gRPC的查询。对多数据中心和联邦集群的支持非常成熟。 | 核心功能。支持基于DNS(通过NIOS)和HTTP/OpenAPI的查询。内置了完整的服务管理控制台,易用性高。 |
| 2. 配置管理 | 通过 Consul KV(键值存储)实现。功能相对基础,适合存储简单的配置项。与Vault(专注密钥)区分明确。 | 核心功能。提供完整的配置管理服务,支持动态配置推送、配置版本管理、灰度发布、监听查询。功能更丰富,是其两大支柱之一。 |
| 3. 健康检查 | 极其强大。是其服务发现可靠性的基石。支持多种检查方式:脚本、HTTP、TCP、TTL、Docker、gRPC等。故障节点会被迅速从服务列表中剔除。 | 支持。提供临时实例(客户端上报心跳)和持久化实例(服务器端主动探测)两种健康检查模式,更灵活。 |
| 4. 多数据中心与集群 | 原生、一流支持。多数据中心是其核心设计目标,跨数据中心的服务发现和故障转移方案非常成熟。 | 支持。通过 Nacos Sync 等组件或集群模式实现,但其原生多数据中心/地域同步能力不如Consul成熟和直接。 |
| 5. 服务网格/安全通信 | 强项。通过 Consul Connect 提供原生服务网格功能,支持mTLS加密和基于身份的授权,无需额外Sidecar代理(可选Envoy)。 | 不直接提供。通常需要与 Istio、Spring Cloud Gateway 等独立的服务网格或网关方案集成来实现类似能力。 |
| 6. 易用性与学习曲线 | 概念相对较多(Agent、Server、Client、Datacenter等),命令行和API为主,有Web UI但功能较基础。学习曲线较陡。 | 极易上手。提供非常直观、功能丰富的Web管理控制台。中文文档和社区支持好,对Spring Cloud/Alibaba生态用户尤其友好。 |
| 7. 生态与集成 | 深度集成HashiCorp全家桶(Terraform, Vault等),与Kubernetes、Envoy集成良好。在非Java生态(如Go, .NET)中也很常见。 | 深度融入Spring Cloud/Alibaba生态,是Spring Cloud Alibaba的核心组件。对Dubbo、gRPC等RPC框架支持原生。在Kubernetes中作为应用级注册中心。 |
| 8. 部署与运维 | 用Go编写,单一二进制文件,部署简单。集群模式需要区分Server和Client节点。 | 用Java编写,依赖Java环境。部署时通常需要外置数据库(如MySQL)用于持久化配置,增加了运维复杂度(也支持内嵌Derby)。 |
架构与模型差异
- 数据一致性模型:
- Consul:默认使用强一致的 Raft 协议来保证Server节点间数据的一致性,这牺牲了一定的写入性能,但保证了数据的可靠性,符合其基础设施的定位。
- Nacos:提供了 AP(分布式可用性) 和 CP(一致性) 两种模式供用户选择。默认是AP模式(使用自研的Distro协议),保证高可用和分区容错,适合服务发现场景;在需要强一致性的配置管理或网络分区场景下,可切换到CP模式(使用Raft协议)。这是Nacos一个非常关键的设计优势。
- 服务模型:
- Consul将服务(Service)注册到节点(Node)上,更贴近物理/虚拟主机的基础设施视角。
- Nacos直接将服务(Service)作为一级实体,实例(Instance)属于服务,更贴近微服务应用的视角。
典型使用场景
- 选择 Consul 更合适的情况:
- 需要构建跨多个数据中心的统一服务网络。
- 对服务间通信的安全性和身份认证有严格要求,希望原生集成服务网格(mTLS)。
- 技术栈多样化(非Java为主),或已在使用HashiCorp生态的其他工具。
- 将服务发现视为基础设施,需要极高的可靠性和强一致性。
- 选择 Nacos 更合适的情况:
- 技术栈以 Java/Spring Cloud (尤其是 Spring Cloud Alibaba) 为主。
- 需要一体化的服务发现与配置管理中心,且对动态配置管理功能要求很高(如灰度发布、版本回滚)。
- 追求快速上手、易于运维,有丰富的可视化界面需求。
- 主要部署在单一数据中心或云Region内,对多数据中心联邦需求不迫切。
- 需要根据业务场景在服务的 AP(高可用)和 CP(强一致) 模式间灵活切换。
总结对比表(快速参考)
| 项目 | Consul | Nacos |
|---|---|---|
| 核心优势 | 多数据中心、服务网格、安全性、强一致性 | 一站式解决方案、配置管理、易用性、生态集成(Spring Cloud) |
| 配置管理 | 基础(KV存储) | 丰富(核心功能,含动态推送) |
| 服务网格 | 原生支持(Consul Connect) | 需集成第三方(如Istio) |
| 数据一致性 | 默认CP(强一致) | 可选AP/CP(默认AP,更灵活) |
| 多数据中心 | 原生支持,非常成熟 | 支持,但方案相对复杂 |
| 主要生态 | HashiCorp全家桶、多云/混合云、K8s | Spring Cloud Alibaba、Dubbo、K8s(应用层) |
| 学习成本 | 较高 | 较低 |
简单来说,Consul更像一个专注于服务网络和安全的基础设施工程师,而Nacos更像一个致力于提升应用开发效率的开发者的伙伴。
选择哪一个,最终取决于你的技术栈、团队熟悉度、核心需求(是否需要强配置管理或多数据中心)以及长期架构规划。对于大多数国内基于Spring Cloud的微服务项目,Nacos是更自然、更高效的选择;对于追求多云/混合云基础设施统一和强安全性的场景,Consul则更具优势。
Q:有用过其它Web容器吗?
目前主流的Web容器选择多样,各有侧重。为了帮助你快速把握核心差异,我将它们的关键信息整理成了以下表格:
| 容器名称 | 官方组织/公司 | 核心定位与特点 | 性能与轻量级 | 配置与部署 | 主要适用场景 |
|---|---|---|---|---|---|
| Apache Tomcat | Apache软件基金会 | 轻量级Servlet/JSP容器,严格遵循Java EE (Jakarta EE) Web Profile规范。以稳定、简单著称。 | 轻量,启动快,资源占用相对较少。 | 主要依赖server.xml等XML文件配置。可独立部署,也可嵌入。 | 传统Java Web应用、Spring Boot默认内置容器、对完整Java EE特性需求不高的项目。 |
| Eclipse Jetty | Eclipse基金会 | 高并发、易嵌入的Web服务器和Servlet容器。设计强调模块化和可插拔。 | 轻量级,在高并发长连接场景下性能表现优异。 | 支持XML、API或代码配置,嵌入到应用程序中非常简单。 | 嵌入式应用(如框架内置)、高实时性应用(如聊天、推送)、微服务、测试环境。 |
| WildFly (原JBoss) | Red Hat | 全功能的Java EE (Jakarta EE) 应用服务器。提供完整的Java EE规范支持。 | 相比Tomcat和Jetty更重,但提供了企业级特性和集群能力。 | 采用子系统模块化管理,支持命令行和Web管理控制台。 | 需要完整Java EE服务(如EJB, JMS, 分布式事务)的企业级复杂应用。 |
| WebSphere Liberty | IBM | 轻量、快速、模块化的应用服务器。基于特性动态加载运行组件。 | 启动快(秒级),占用资源少。可根据应用需要仅加载必要的特性。 | 核心配置是server.xml文件。支持将服务器打包成可运行JAR。 | 云原生和微服务架构、需要快速迭代的现代Java应用、IBM技术栈环境。 |
| Undertow | Red Hat | 高性能、嵌入式Web服务器。为灵活性和极致性能而生,是WildFly的默认Web容器。 | 性能突出,资源占用极低,专为嵌入设计和优化。 | 完全通过Java API编程式配置,不提供XML等外部配置文件。 | 需要极致性能的嵌入式场景、作为其他框架(如Spring Boot)的底层服务器、定制化网络应用。 |
注:上述容器中,Tomcat、Jetty、Undertow通常被称为“Web容器”或“Web服务器”,主要提供Servlet/JSP运行环境。而WildFly和WebSphere Liberty是“Java EE应用服务器”,除了Web容器功能,还额外提供了EJB、JMS、JTA等完整的Java EE企业服务。
如何选择合适的Web容器?
你可以根据以下常见场景来做选择:
- 开发Spring Boot应用:从内置的Tomcat开始最简单;如果追求更高性能或需要更灵活的嵌入控制,可以考虑切换到Undertow或Jetty。
- 构建传统的企业级应用:如果需要用到EJB、JMS等完整Java EE功能,应选择WildFly或WebSphere Liberty;如果只是一个纯粹的Web MVC应用,使用Tomcat或Jetty搭配Spring等框架即可。
- 实现嵌入式或云原生微服务:优先考虑Undertow、Jetty或WebSphere Liberty,因为它们启动快、资源占用低且易于嵌入和打包。
- 处理高并发、大量长连接:Jetty和Undertow在异步和非阻塞I/O处理上具有优势,适合实时通信、游戏服务器等场景。
一、核心概念:什么是 Web 容器?
简单来说,Web 容器(或Servlet容器) 是运行 Java Web 应用的一个“中间环境”。它的核心任务是 处理网络请求 和 管理 Servlet 的生命周期。
你可以把它想象成一个 “翻译官”和“调度员”:
- 翻译:将来自客户端(如浏览器)的 HTTP 请求,转换成 Java 对象(
HttpServletRequest),让 Java 程序能理解并处理。 - 调度:根据请求的 URL,找到并调用对应的 Servlet(即你写的业务处理类)。
- 管理:负责创建、初始化、调用和销毁 Servlet 实例,并提供会话管理、安全性等通用服务。
我们常听到的 “应用服务器”(如 WildFly, WebLogic)是 功能更强大的容器,它不仅包含了 Web 容器,还提供了全套的企业级服务,如 EJB、JMS、分布式事务等。
二、技术核心与架构演进
Web 容器的性能核心在于其 I/O 模型(如何处理网络连接和请求)。
| 架构模型 | 核心工作原理 | 特点与代表容器 |
|---|---|---|
| 传统阻塞式I/O | 一个请求分配一个独立线程处理。线程在等待数据库等操作时会阻塞,直到完成才能处理下一个请求。 | 模型简单,但并发线程数受限于线程池大小。 早期 Tomcat(BIO模式)是典型代表。 |
| 非阻塞式I/O | 使用少量线程处理大量连接。当请求需要等待外部资源时,线程会被释放去处理其他请求,资源就绪后回调处理。 | 能更好地应对高并发、长连接(如 WebSocket)。 Tomcat(NIO/APR模式)、Jetty、Undertow 都采用此模式,是当前主流。 |
| 异步Servlet | 在 NIO 基础上,允许 Servlet 将耗时操作(如调用另一个API)从请求线程中剥离,交给其他线程池处理,从而立即释放请求线程。 | 进一步解放容器线程,提升吞吐量。 Servlet 3.0+ 规范支持,主流容器均已实现。 |
三、主流 Web 容器深度解析
除了上次表格中的特点,这里从 应用趋势 和 核心差异 角度补充:
- Apache Tomcat
- 社区与生态:拥有最庞大的用户群和社区,任何问题都能轻易找到资料和解决方案。
- “标准”的体现:它几乎成为了 Servlet 技术的参考实现。许多开发者学习 Web 开发都是从 Tomcat 开始的。
- 在云原生时代:凭借其简单和稳定,依然是 Spring Boot 等框架 默认的嵌入式选择。
- Eclipse Jetty
- 设计哲学:高度的模块化和可插拔。你可以像搭积木一样,只加载应用需要的组件。
- 异步能力:其核心从设计之初就为异步和非阻塞优化,在处理大量并发、低延迟的通信(如实时数据推送)方面表现出色。
- Undertow
- 性能优势:由 JBoss 团队开发,设计目标是极致性能和低内存开销。其核心非常精简,没有传统的 XML 配置,一切通过 API 编程。
- 角色定位:它不仅是独立的 Web 服务器,更是 WildFly 应用服务器的底层引擎。由于其优秀的性能,许多追求性能的 Spring Boot 项目会用它替换默认的 Tomcat。
- WildFly / JBoss EAP
- “全家桶”:它不仅仅是一个 Web 容器。如果你需要消息队列(JMS)、分布式事务(JTA)、企业级 Bean(EJB)等完整的企业级功能,选择它意味着这些服务都经过深度整合和测试,开箱即用。
- IBM WebSphere Liberty
- “按需付费”式运行时:其“特性”机制非常先进。如果你只是运行一个简单的 Web 应用,它加载的运行时与一个需要完整微服务 Profile 的应用完全不同,做到了真正的轻量。
- 快速迭代:启动时间通常只需几秒,非常适合在开发和云环境中快速部署和扩展。
四、现代架构中的新角色:嵌入式容器
这是微服务架构带来的重大变化。传统上,你需要先安装并启动一个独立的 Tomcat,再将 WAR 包部署上去。而现在,应用将自己和所需的 Web 容器库一起打包成一个可执行的 JAR 包。
- 优势:应用自成一体,启动更快,部署更简单,更适合 Docker 和 Kubernetes 环境。
- 实践:Spring Boot 是这一模式的强力推动者。它默认内嵌了 Tomcat,并允许你通过修改一行 Maven/Gradle 依赖,轻松地将容器切换为 Jetty 或 Undertow。
五、如何做出技术选型:一个决策框架
当面对选择时,你可以问自己以下几个问题:
- 我的应用类型是什么?
- 简单的单体Web应用或REST API:Tomcat 是稳妥、省心的首选。
- 需要极致性能的微服务或实时应用:认真考虑 Undertow 或 Jetty。
- 需要EJB等完整Java EE特性的传统企业应用:必须选择 WildFly 或类似的应用服务器。
- 部署和运维模式是什么?
- 独立部署:所有容器都支持。Tomcat 的运维知识最普及。
- 嵌入式/云原生部署:优先考虑 Jetty、Undertow、Liberty 或 嵌入式Tomcat。
- 需要强大的管理控制台和集群支持:WildFly 或 WebSphere Liberty 的企业级功能更完善。
- 团队熟悉什么?
- 选择团队最熟悉的技术可以降低学习成本和运维风险。Tomcat 在这方面有无与伦比的优势。
针对 Spring Boot 项目和微服务架构,选择就变得非常清晰和聚焦了。在微服务场景下,我们追求的是 快速启动、低内存消耗、高性能和非阻塞处理能力,因此通常会在 嵌入式容器 中进行选择。
Spring Boot 默认为我们内置了 Tomcat,但它允许你非常方便地切换到 Jetty 或 Undertow。
六、三大嵌入式容器对比(Spring Boot 视角)
| 特性维度 | Apache Tomcat (Spring Boot 默认) | Eclipse Jetty | Undertow |
|---|---|---|---|
| 核心定位 | 普适、稳定、生态第一 | 异步优先、长连接专家 | 性能极致、资源节约 |
| 启动速度 | 快 | 非常快 | 极快 |
| 内存占用 | 中等 | 较低 | 极低 |
| 并发性能 | 优秀,满足绝大多数场景 | 卓越,尤其在大量持久连接(如WebSocket、消息推送)场景下 | 顶尖,尤其在短连接、高吞吐的REST API场景下 |
| 设计哲学 | 稳健、模块化、配置丰富 | 完全异步、高度模块化、可插拔 | 基于NIO2、无阻塞、精简核心、仅API配置 |
| 适用微服务场景 | 标准REST API服务、通用业务微服务(80%的场景) | 实时通信服务、流处理、IoT网关(需要大量WebSocket或Server-Sent Events) | 高吞吐、低延迟的API网关、核心计算服务、资源受限环境 |
如何做出你的选择
1. 默认选择:坚持使用 Tomcat
- 理由:无需任何额外配置,拥有最广泛的社区知识库,与Spring生态整合毫无瑕疵。如果你的服务是标准的 CRUD 或 REST API,并发量在常规范围(如 QPS < 10000),Tomcat 的性能完全足够且稳定可靠。
- 何时选:当你不确定该换什么,或者团队对 Tomcat 最熟悉时,不要改变默认设置就是最好的选择。
2. 考虑切换到 Jetty
- 理由:Jetty 从一开始就为异步和非阻塞设计,其线程模型在高并发长连接场景下更具弹性,能更高效地管理成千上万个空闲连接。
- 何时选:当你的微服务是聊天应用、实时数据仪表盘、协同编辑工具等需要大量 WebSocket 或长轮询连接时。
3. 考虑切换到 Undertow
- 理由:由 Red Hat 的 JBoss 团队开发,以极致的性能和低内存开销为目标。在许多第三方压测中,其 HTTP 响应吞吐量和延迟表现优于 Tomcat 和 Jetty。
- 何时选:当你的微服务是高频交易系统、API 网关、图像处理服务等对吞吐量和响应延迟有极致要求,或者你希望在有限的硬件资源(如小内存容器)上运行更多服务实例时。
实践指南
1. 如何切换容器?(以 Maven 为例) 在 pom.xml 中,排除默认的 Tomcat,并引入你选择的容器依赖即可。
<!-- 从 Spring Boot Web 启动器中排除 Tomcat -->
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-web</artifactId>
    <exclusions>
        <exclusion>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-tomcat</artifactId>
        </exclusion>
    </exclusions>
</dependency>

<!-- 然后,二选一添加 -->
<!-- 选项 A: 使用 Jetty -->
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-jetty</artifactId>
</dependency>

<!-- 选项 B: 使用 Undertow -->
<dependency>
    <artifactId>spring-boot-starter-undertow</artifactId>
</dependency>
2. 至关重要的步骤:基准测试不要迷信任何理论数据。在你自己的服务和硬件环境下进行压测是唯一可靠的选型依据。
- 测试工具:使用 JMeter、Gatling 或 wrk。
- 测试场景:模拟你的真实业务请求(如登录、查询、下单),并逐步增加并发用户数。
- 关键指标:
- 响应时间(P95, P99):特别是高百分位的延迟,这直接影响用户体验。
- 吞吐量(Requests/sec):系统每秒能处理的请求数。
- 内存和CPU使用率:在同等压力下,哪个容器更节省资源。
- 测试方法:使用相同的应用代码,仅切换容器依赖,在相同环境下进行多次测试取平均值。
总结与直接建议
对于 Spring Boot 微服务项目:
- 起步和大多数情况:坚持使用 Spring Boot 默认的 Tomcat。它是经过无数验证的可靠选择。
- 如果你的服务有大量实时、长连接需求:尝试切换到 Jetty,并观察其在线程使用和连接管理上的表现。
- 如果你在压测中发现 Tomcat 成为性能瓶颈,或对资源消耗极其敏感:果断切换到 Undertow,它很可能会带来显著的性能提升。
最后,一个微服务架构中允许混合使用不同的容器。你可以为网关服务使用 Undertow,为实时通知服务使用 Jetty,为普通的业务服务使用 Tomcat。这种根据服务特点精细化选型,是微服务架构的优势之一。
Q.E.D.